Das richtige Monitoring-Intervall ist das kürzeste, das dein SLA verlangt und deine Toleranz für Alarmrauschen zulässt. Für die meisten Produktiv-Websites sind das 1-5 Minuten. Auf 30 Sekunden oder weniger gehst du nur dort, wo jede Minute Ausfallzeit direkt Geld kostet. Prüfst du zu selten, laufen Ausfälle länger, bevor sie jemandem auffallen. Prüfst du zu oft, verschwendest du Budget und Probe-Kapazität für redundante Anfragen und riskierst Fehlalarme durch kurzzeitige Aussetzer.
Warum das Prüfintervall ein Kompromiss ist und keine bloße Einstellung
Jeder Monitoring-Check hat eine eingebaute Erkennungsverzögerung. Prüfst du alle 5 Minuten, verpasst du im schlimmsten Fall einen Ausfall, der eine Sekunde nach einem Check beginnt und bis zum nächsten andauert: volle 5 Minuten unbemerkte Downtime. Im Durchschnitt über viele Ausfälle liegt die Erkennungsverzögerung bei etwa der Hälfte des Intervalls. Ein 5-Minuten-Intervall bringt dir also eine durchschnittliche Verzögerung von ~2,5 Minuten und im schlimmsten Fall 5 Minuten.
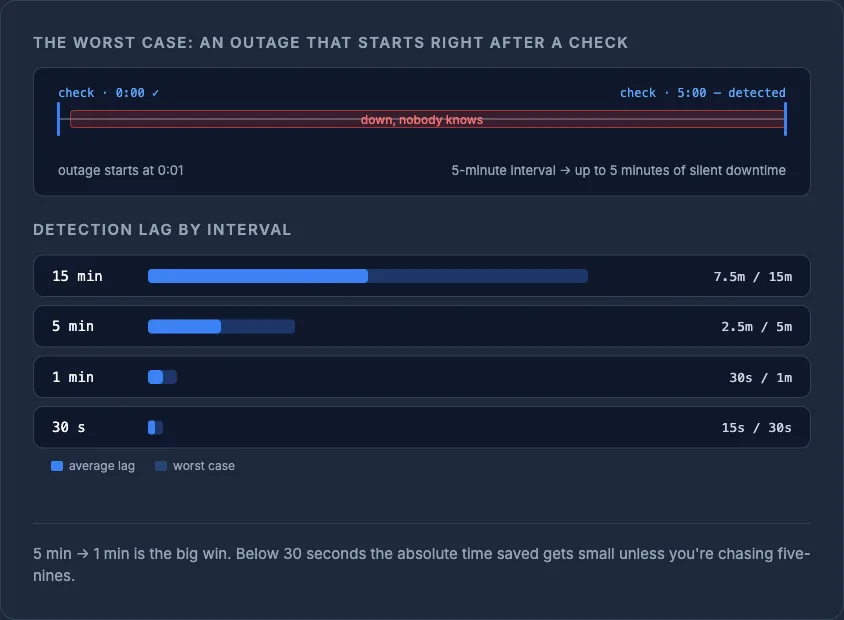
Diese Verzögerung zählt, weil sie direkt von deinem Downtime-Budget abgeht. Ein kürzeres Intervall verhindert keine Ausfälle. Es verkleinert aber die Lücke zwischen dem Beginn eines Ausfalls und dem Moment, in dem du davon erfährst. Oft entscheidet genau das, ob es bei einer stillen Behebung bleibt oder eine verärgerte Kunden-E-Mail kommt.
Prüfintervall ans SLA anpassen: die Downtime-Rechnung
Wenn du einen bestimmten Uptime-Prozentsatz zusagst (oder brauchst), rechne vom monatlichen Downtime-Budget rückwärts, das sich daraus ergibt:
| Uptime-Ziel | Downtime-Budget / Monat | Sinnvolles Prüfintervall |
|---|---|---|
| 99% | ~7,2 Stunden | 5-15 Minuten |
| 99.9% | ~43,2 Minuten | 1-5 Minuten |
| 99.95% | ~21,6 Minuten | 1 Minute |
| 99.99% | ~4,3 Minuten | 30 Sekunden oder weniger |
| 99.999% | ~26 Sekunden | Kontinuierlich / unter 10 Sekunden, mehrere Regionen |
Das Muster ist eindeutig: Ein 5-Minuten-Check kann allein schon den Großteil eines 99,9-%-Budgets aufbrauchen, wenn er einen einzigen Vorfall spät erkennt. Strengere SLAs erzwingen deshalb kürzere Intervalle. Rechne die Zahlen für dein eigenes Ziel mit unserem Uptime-Rechner durch, bevor du dich vertraglich auf ein SLA festlegst. Man verspricht schnell eine Zahl, die der eigene Monitoring-Takt gar nicht absichern kann.
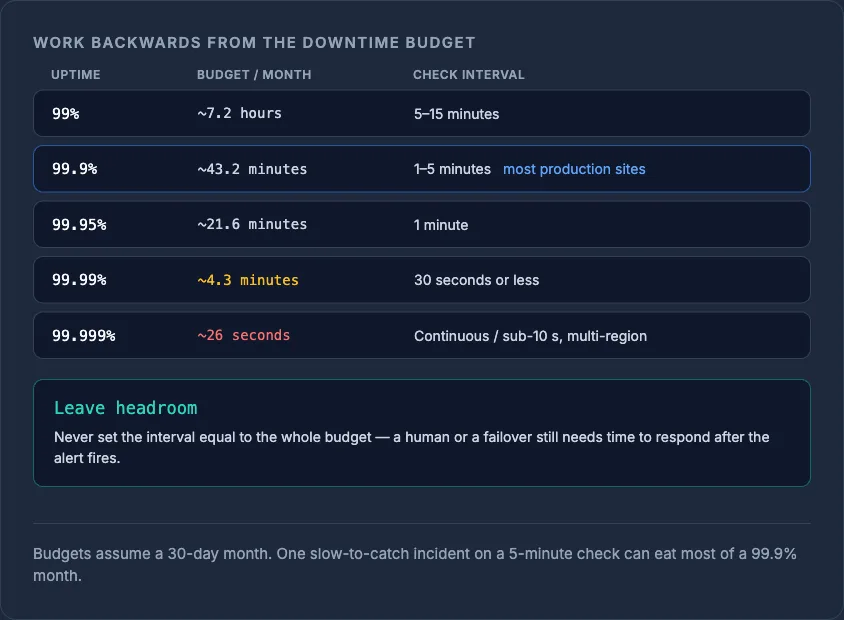
TipSetze dein Prüfintervall nicht gleich deinem gesamten Downtime-Budget. Lass Spielraum für die Zeit, die ein Mensch (oder ein automatisches Failover) braucht, um nach einem Alarm tatsächlich zu reagieren.
Welche Prüfintervalle Monitoring-Anbieter tatsächlich bieten
Monitoring-Anbieter bewegen sich meist in einigen typischen Stufen. Es lohnt sich, die Bandbreite zu kennen, bevor du dich entscheidest:
- 5 Minuten: typische Voreinstellung im Gratis-Tarif der meisten Uptime-Monitoring-Tools; ausreichend für Websites mit wenig Traffic, Blogs und interne Tools.
- 1 Minute: übliche Basis in Bezahl-Tarifen; ein vernünftiger Standard für die meisten Produktiv-Websites und APIs.
- 30 Sekunden oder weniger: in höheren Tarifen der meisten großen Monitoring-Plattformen und als kostenpflichtige Option bei Cloud-nativen Health Checks verfügbar; reserviert für umsatzkritische Endpunkte.
- 10 Sekunden: bei manchen Health-Check-Diensten von Cloud-Anbietern als Premium-/Schnellintervall-Option gegen Aufpreis erhältlich.
Einen allgemeingültigen Standard gibt es hier nicht, und Anbieter ändern ihre Preisstufen. Betrachte diese Werte beim Vergleichen von Tarifen daher als Bandbreiten, nicht als feste Zahlen.
Warum häufiger prüfen nicht automatisch besser ist
Jeden Check alle 10-30 Sekunden laufen zu lassen, klingt sicherer, hat aber echte Nachteile:
- Alarmmüdigkeit. Kurze Netzwerkaussetzer, ein langsamer DNS-Resolver oder ein einzelnes verlorenes Paket können für einen Prüfzyklus wie ein Ausfall aussehen. Die meisten Tools fangen das ab, indem sie mehrere aufeinanderfolgende Fehlschläge verlangen, oft von verschiedenen Probe-Standorten, bevor sie Alarm schlagen. Genau deshalb musst du Intervall und Alarmschwelle gemeinsam abstimmen, nicht isoliert.
- Kosten und Probe-Last. Häufige Checks aus mehreren Regionen vervielfachen das Anfragevolumen auf deinem Origin. Für die meisten Websites ist das vernachlässigbar, im großen Maßstab summiert es sich aber, vor allem wenn du zusätzlich synthetische Transaktions-Checks fährst, die mehr tun als ein simples GET.
- Abnehmender Nutzen. Der Schritt von 5 Minuten auf 1 Minute verkürzt die maximale Erkennungsverzögerung spürbar. Von 30 auf 10 Sekunden verkürzt sie sich weiter, die absolut gewonnene Zeit ist aber gering, es sei denn, du jagst Five Nines hinterher.
Unterschiedliche Checks, unterschiedliche Prüfintervalle
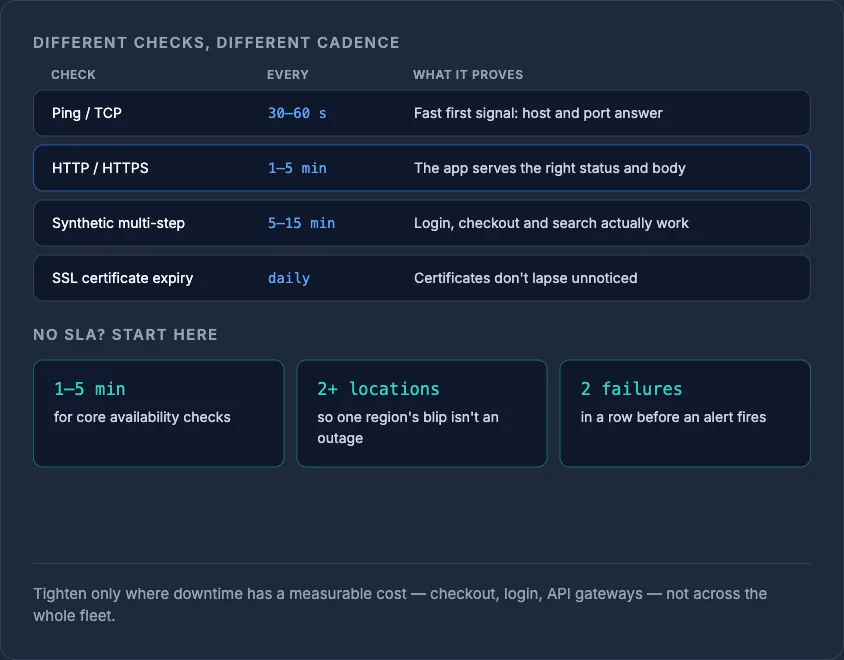
Nicht jeder Check in deinem Stack braucht denselben Takt. Üblich und sinnvoll ist zum Beispiel:
- Ein schlanker Ping- oder TCP-Check alle 30-60 Sekunden als schnelles erstes Signal.
- Ein HTTP/HTTPS-Check, der Statuscode und Response-Body prüft, alle 1-5 Minuten. Erst er belegt, dass die Anwendung tatsächlich korrekt ausliefert und nicht nur der Port offen ist. In Ping vs. HTTP vs. HTTPS Monitoring erfährst du, was jeder Check-Typ tatsächlich nachweist.
- Checks auf SSL-Zertifikatsablauf täglich: Zertifikate laufen nicht innerhalb von Sekunden ab, minütliches Prüfen bringt also nichts. In Website-Monitoring erklärt siehst du, wie Uptime-, Performance- und SSL-Checks zusammenspielen.
- Synthetische mehrstufige Checks (Login, Checkout, Suche) seltener, alle 5-15 Minuten, da sie schwerer und langsamer sind als ein einfacher Ping.
Eine praktische Faustregel
Wenn du kein formelles SLA hast, nimm das als Ausgangspunkt: Prüfe die Kernverfügbarkeit alle 1-5 Minuten von mindestens zwei geografischen Standorten aus, verlange zwei aufeinanderfolgende Fehlschläge vor einem Alarm und ergänze tägliche Checks für alles, was sich langsam ändert, etwa SSL-Ablauf oder DNS-Einträge. Erhöhe die Frequenz nur für Endpunkte, bei denen Downtime messbare Kosten verursacht (Checkout, Login, API-Gateways), statt standardmäßig überall das kürzeste Intervall anzuwenden.
Mit dem Monitoring von InfraNest legst du Intervalle pro Endpunkt und Alarmschwellen über mehrere Standorte fest. So kann deine Checkout-Seite enger überwacht werden als dein Marketing-Blog, ohne dass du für maximale Frequenz über deine gesamte Infrastruktur bezahlst.
Berechne dein eigenes Downtime-Budget mit dem Uptime-Rechner und stelle dein Prüfintervall dann so ein, dass es dieses Budget tatsächlich schützt.
Häufig gestellte Fragen
#Welches Prüfintervall ist ein guter Standard, wenn ich kein SLA habe?
Prüfe deine Kernseiten alle 1-5 Minuten von mindestens zwei Standorten aus und verlange zwei aufeinanderfolgende Fehlschläge vor einem Alarm, um Fehlalarme durch kurze Netzwerkaussetzer zu vermeiden.
#Verringert ein kürzeres Prüfintervall die tatsächliche Downtime?
Nein. Es verhindert keine Ausfälle, verkürzt aber die Erkennungsverzögerung, also die Zeit zwischen dem Beginn eines Ausfalls und dem Moment, in dem du davon erfährst. So kannst du schneller reagieren.
#Sollte jede Seite meiner Website dasselbe Monitoring-Intervall nutzen?
Nein. Umsatzkritische Pfade wie Checkout oder Login rechtfertigen kürzere Intervalle, während sich langsam ändernde Checks wie SSL-Ablauf oder DNS-Einträge nur einmal am Tag laufen müssen.
#Kann zu häufiges Monitoring Probleme verursachen?
Ja. Sehr kurze Intervalle erhöhen das Risiko von Fehlalarmen durch kurzzeitige Aussetzer und erzeugen unnötige Anfragelast. Deshalb kombinieren die meisten Tools kurze Intervalle mit Alarmschwellen, die mehrere Checks von mehreren Standorten voraussetzen.
Mit einem kostenlosen Tool ausprobieren
War dieser Artikel hilfreich?