Le bon intervalle de surveillance est le plus court qu'exige votre SLA et que votre tolérance au bruit des alertes permet : pour la plupart des sites en production, c'est 1-5 minutes, en descendant à 30 secondes ou moins uniquement là où chaque minute d'indisponibilité a un coût direct. Vérifier trop rarement, c'est laisser les pannes durer plus longtemps avant que quelqu'un ne les remarque ; vérifier trop souvent, c'est gaspiller du budget et de la capacité de sondes en requêtes redondantes, et risquer de fausses alertes dues à des micro-coupures passagères.
Pourquoi l'intervalle de surveillance est un compromis, pas un simple réglage
Chaque vérification comporte un délai de détection intrinsèque. Si vous vérifiez toutes les 5 minutes, le pire scénario est une panne qui commence une seconde après une vérification et dure jusqu'à la suivante : 5 minutes complètes d'indisponibilité silencieuse. En moyenne, sur de nombreuses pannes, le délai de détection correspond à peu près à la moitié de l'intervalle. Un intervalle de 5 minutes donne donc un délai moyen d'environ 2,5 minutes et un délai maximal de 5 minutes.
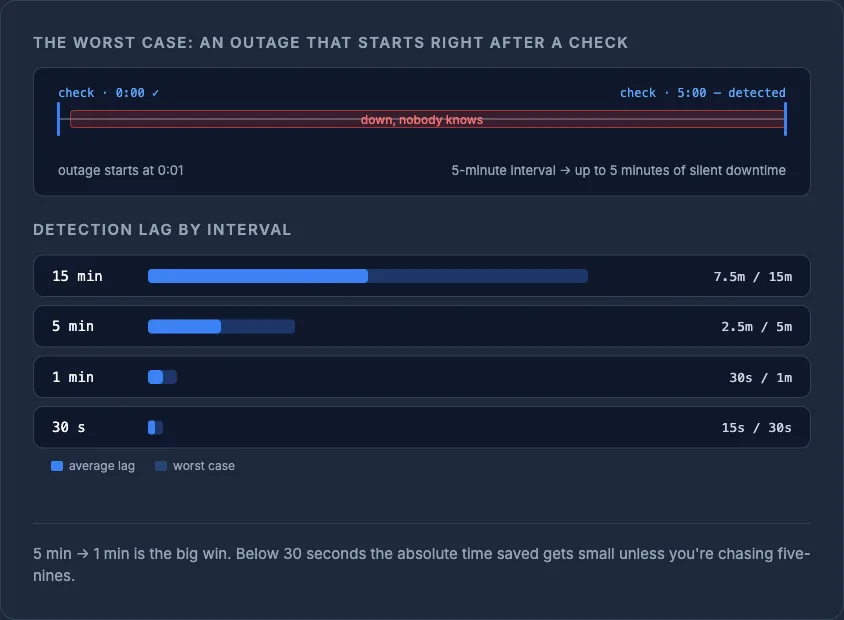
Ce délai compte, car il ronge directement votre budget d'indisponibilité. Un intervalle plus court n'empêche pas les pannes, mais il réduit l'écart entre le début d'une panne et le moment où vous en êtes informé, ce qui fait souvent la différence entre une correction discrète et l'e-mail d'un client furieux.
Adapter l'intervalle à votre SLA grâce au calcul du temps d'indisponibilité
Si vous promettez (ou devez atteindre) un pourcentage de disponibilité précis, partez du budget d'indisponibilité mensuel qu'il implique :
| Objectif de disponibilité | Budget d'indisponibilité / mois | Intervalle de vérification conseillé |
|---|---|---|
| 99% | ~7.2 heures | 5-15 minutes |
| 99.9% | ~43.2 minutes | 1-5 minutes |
| 99.95% | ~21.6 minutes | 1 minute |
| 99.99% | ~4.3 minutes | 30 secondes ou moins |
| 99.999% | ~26 secondes | En continu / moins de 10 secondes, multirégion |
La logique est simple : une vérification toutes les 5 minutes peut à elle seule consommer l'essentiel d'un budget de 99.9% si elle tarde à détecter un seul incident ; des SLA plus exigeants imposent donc des intervalles plus courts. Faites le calcul pour votre propre objectif avec notre calculateur de disponibilité avant de vous engager sur un SLA dans un contrat : il est facile de promettre un chiffre que votre fréquence de surveillance ne permet pas réellement de garantir.
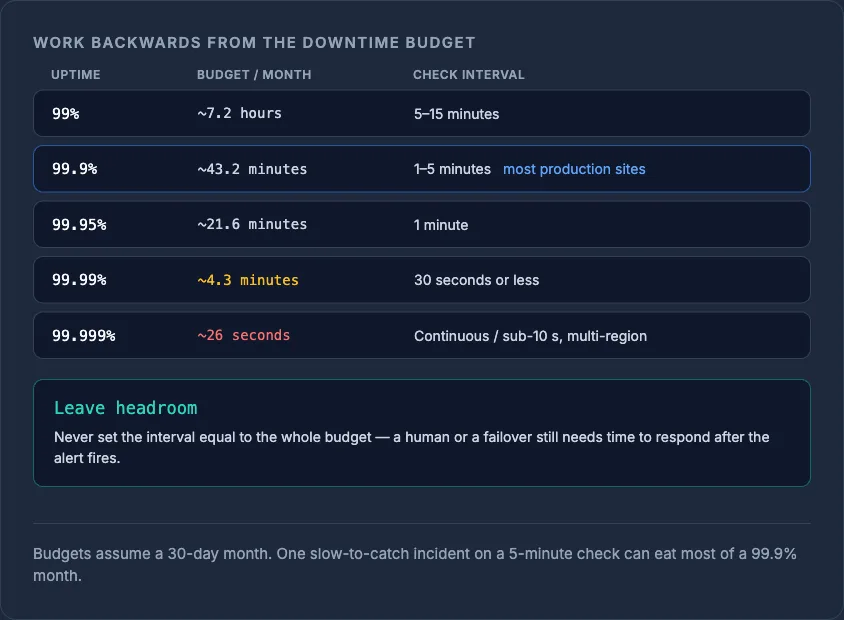
TipNe fixez pas votre intervalle de vérification à la totalité de votre budget d'indisponibilité. Gardez une marge pour le temps nécessaire à un humain (ou à un basculement automatique) pour réagir une fois l'alerte déclenchée.
Ce que proposent réellement les outils de monitoring
Les fournisseurs de monitoring se regroupent autour de quelques paliers courants, et il est utile de connaître la fourchette avant de choisir :
- 5 minutes : valeur par défaut typique des offres gratuites de la plupart des outils d'uptime monitoring ; suffisant pour les sites à faible trafic, les blogs et les outils internes.
- 1 minute : référence courante des offres payantes ; une valeur par défaut raisonnable pour la plupart des sites et API en production.
- 30 secondes ou moins : disponible sur les offres supérieures de la plupart des grandes plateformes de monitoring et en option payante sur les health checks cloud natifs ; réservé aux endpoints critiques pour le chiffre d'affaires.
- 10 secondes : proposé comme option premium à intervalle rapide sur certains services de health check des fournisseurs cloud, moyennant un surcoût.
Il n'existe pas de norme universelle en la matière, et les fournisseurs modifient leurs grilles tarifaires : considérez ces valeurs comme des fourchettes plutôt que comme des chiffres fixes lorsque vous comparez les offres.
Pourquoi surveiller plus souvent n'est pas forcément mieux
Lancer chaque vérification toutes les 10-30 secondes semble plus sûr, mais cela a de vrais coûts :
- La fatigue des alertes. Une micro-coupure réseau passagère, un résolveur DNS lent ou un seul paquet perdu peuvent ressembler à une panne pendant un cycle de vérification. La plupart des outils atténuent ce problème en exigeant plusieurs échecs consécutifs, souvent depuis différents emplacements de sondes, avant de déclencher une alerte. C'est précisément pour cela que l'intervalle et le seuil d'alerte doivent être réglés ensemble, et non séparément.
- Le coût et la charge des sondes. Des vérifications fréquentes depuis plusieurs régions multiplient le volume de requêtes sur votre serveur d'origine. Pour la plupart des sites, c'est négligeable, mais à grande échelle cela s'accumule, surtout si vous exécutez aussi des vérifications de transactions synthétiques qui font plus qu'un simple GET.
- Des rendements décroissants. Passer de 5 minutes à 1 minute réduit sensiblement le délai de détection maximal. Passer de 30 secondes à 10 secondes le réduit encore, mais le temps gagné en valeur absolue est faible, sauf si vous visez les « cinq neuf ».
À chaque type de vérification son intervalle
Toutes les vérifications de votre stack n'ont pas besoin de la même fréquence. Il est courant, et judicieux, d'exécuter :
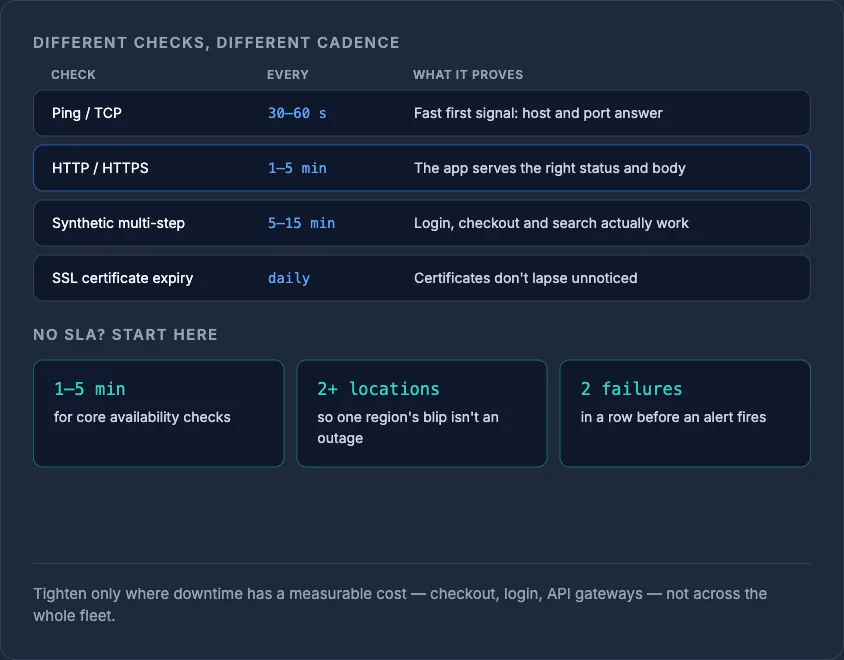
- Une vérification légère ping ou TCP toutes les 30-60 secondes, pour un premier signal rapide.
- Une vérification HTTP/HTTPS qui contrôle le code de statut et le corps de la réponse toutes les 1-5 minutes, car c'est elle qui prouve réellement que l'application répond correctement, et pas seulement que le port est ouvert. Consultez monitoring ping, HTTP ou HTTPS pour savoir ce que prouve réellement chaque type de vérification.
- Des vérifications d'expiration du certificat SSL une fois par jour : les certificats n'expirent pas en quelques secondes, il est donc inutile de les vérifier chaque minute. Voir le monitoring de site web expliqué pour comprendre comment s'articulent les vérifications de disponibilité, de performance et SSL.
- Des vérifications synthétiques en plusieurs étapes (connexion, paiement, recherche) moins fréquemment, toutes les 5-15 minutes, car elles sont plus lourdes et plus lentes à exécuter qu'un simple ping.
Une règle empirique pratique
Si vous n'avez pas de SLA formel, partez de cette base : vérifiez la disponibilité principale toutes les 1-5 minutes depuis au moins deux emplacements géographiques, exigez deux échecs consécutifs avant d'alerter, et ajoutez des vérifications quotidiennes pour tout ce qui évolue lentement, comme l'expiration SSL ou les enregistrements DNS. N'augmentez la fréquence que pour les endpoints dont l'indisponibilité a un coût mesurable (paiement, connexion, passerelles d'API) plutôt que d'appliquer par défaut l'intervalle le plus court partout.
Le monitoring d'InfraNest vous permet de définir des intervalles par endpoint et des seuils d'alerte multi-emplacements, afin que votre page de paiement soit surveillée plus étroitement que votre blog marketing, sans payer la fréquence maximale sur l'ensemble de votre parc.
Calculez votre propre budget d'indisponibilité avec le calculateur de disponibilité, puis réglez votre intervalle de vérification pour le protéger réellement.
Questions fréquentes
#Quel intervalle de vérification par défaut choisir si je n'ai pas de SLA ?
Vérifiez les pages principales toutes les 1-5 minutes depuis au moins deux emplacements, et exigez deux échecs consécutifs avant d'alerter pour éviter les faux positifs dus à des micro-coupures réseau passagères.
#Un intervalle de vérification plus court réduit-il réellement l'indisponibilité ?
Non, il n'empêche pas les pannes, mais il réduit le délai de détection, c'est-à-dire le temps entre le début d'une panne et le moment où vous l'apprenez, ce qui vous permet de réagir plus vite.
#Toutes les pages de mon site doivent-elles utiliser le même intervalle de surveillance ?
Non. Les parcours critiques pour le chiffre d'affaires, comme le paiement ou la connexion, justifient des intervalles plus courts, tandis que les vérifications d'éléments qui évoluent lentement, comme l'expiration SSL ou les enregistrements DNS, n'ont besoin de tourner qu'une fois par jour.
#Une surveillance trop fréquente peut-elle poser problème ?
Oui : des intervalles très courts augmentent le risque de fausses alertes dues à des micro-coupures momentanées et ajoutent une charge de requêtes inutile. C'est pourquoi la plupart des outils associent les intervalles courts à des seuils d'alerte basés sur plusieurs vérifications et plusieurs emplacements.
Essayez avec un outil gratuit
Cet article vous a-t-il été utile ?