Infrastructure Drift ist die Lücke zwischen dem Zustand, den deine Konfiguration oder dein Infrastructure-as-Code (IaC) vorgibt, und dem Zustand, der tatsächlich in Produktion läuft. Er entsteht immer dann, wenn jemand oder etwas eine laufende Ressource ändert – einen Server, eine Firewall-Regel, einen DNS-Eintrag –, ohne die maßgebliche Quelle zu aktualisieren, die sie beschreibt. Bleibt er unbemerkt, wird deine „bekannt gute“ Konfiguration zur Fiktion.
Drift ist kein Bug in einem bestimmten Tool. Er ist ein strukturelles Risiko, wenn Infrastruktur von mehreren Personen, Providern und Automatisierungs-Pipelines betrieben wird – und er nimmt zu, je größer dein Stack wird.
Was ist Infrastructure Drift?
Drift ist jede Abweichung zwischen dem deklarierten Zustand (eine Terraform-Datei, ein CloudFormation-Template, ein DNS-Zonenexport, ein Runbook) und dem beobachteten Zustand (was die API des Providers gerade tatsächlich zurückliefert). Das betrifft fast alles, was eine Konfiguration hat: Compute-Instanzen, Security Groups, Load-Balancer-Regeln, TLS-Zertifikate und DNS-Einträge.
Ein paar konkrete Beispiele:
- Jemand bearbeitet in der AWS-Konsole eine Security-Group-Regel, um ein Deployment freizuschalten, und vergisst dann, die Änderung in Terraform nachzuziehen.
- Ein DNS-Eintrag wird während eines Incidents direkt im Dashboard des Registrars geändert – an der Automatisierung vorbei, die ihn normalerweise verwaltet.
- Eine Autoscaling-Gruppe tauscht während eines Patch-Zyklus ein neues AMI (Amazon Machine Image) ein und ändert damit die Instanzkonfiguration, ohne dass dein IaC davon je erfahren hat.
- Zwei Teams verwalten dieselbe DNS-Zone mit unterschiedlichen Tools – eines per Terraform, eines von Hand – und überschreiben gegenseitig unbemerkt ihre Änderungen.
In jedem dieser Fälle erzählen deine dokumentierte und deine reale Infrastruktur unterschiedliche Geschichten.
Wie Drift entsteht
Drift entsteht fast nie absichtlich. Er schleicht sich über einige altbekannte Wege ein:
- Manuelle Hotfixes. Jemand ändert während eines Incidents eine laufende Ressource, weil das schneller geht als über die Pipeline – und das Folgeticket, um die Änderung zurückzuportieren, wird nie erledigt.
- Automatisierung außerhalb des regulären Prozesses. Ein separates Skript, das Auto-Patching eines Providers oder eine Konsolenaktion eines Support-Engineers ändert eine Ressource, von der dein Haupt-IaC nichts weiß.
- Geteilte Zuständigkeit (Split-Brain). Mehrere Teams oder Tools verwalten dieselbe Ressource – typisch bei DNS, wo ein Registrar-Dashboard, ein CDN und ein Terraform-Modul womöglich alle behaupten, dieselbe Zone zu besitzen.
- Änderungen auf Provider-Seite. Managed Services aktualisieren gelegentlich zugrunde liegende Ressourcen (gepatchte AMIs, rotierte Zertifikate, geänderte Standardwerte), ohne dass du etwas tust.
- Veraltete
ignore_changes-Regeln oder nicht verwaltete Attribute. Wenn dein IaC-Tool bestimmte Felder ignorieren soll oder sie gar nicht erfasst, tauchen Änderungen an diesen Feldern nie als Drift auf – obwohl sie real sind.
Nichts davon setzt Nachlässigkeit voraus. So ist es eben, wenn Infrastruktur mehr als eine Tür hat.
Wie Drift-Erkennung tatsächlich funktioniert
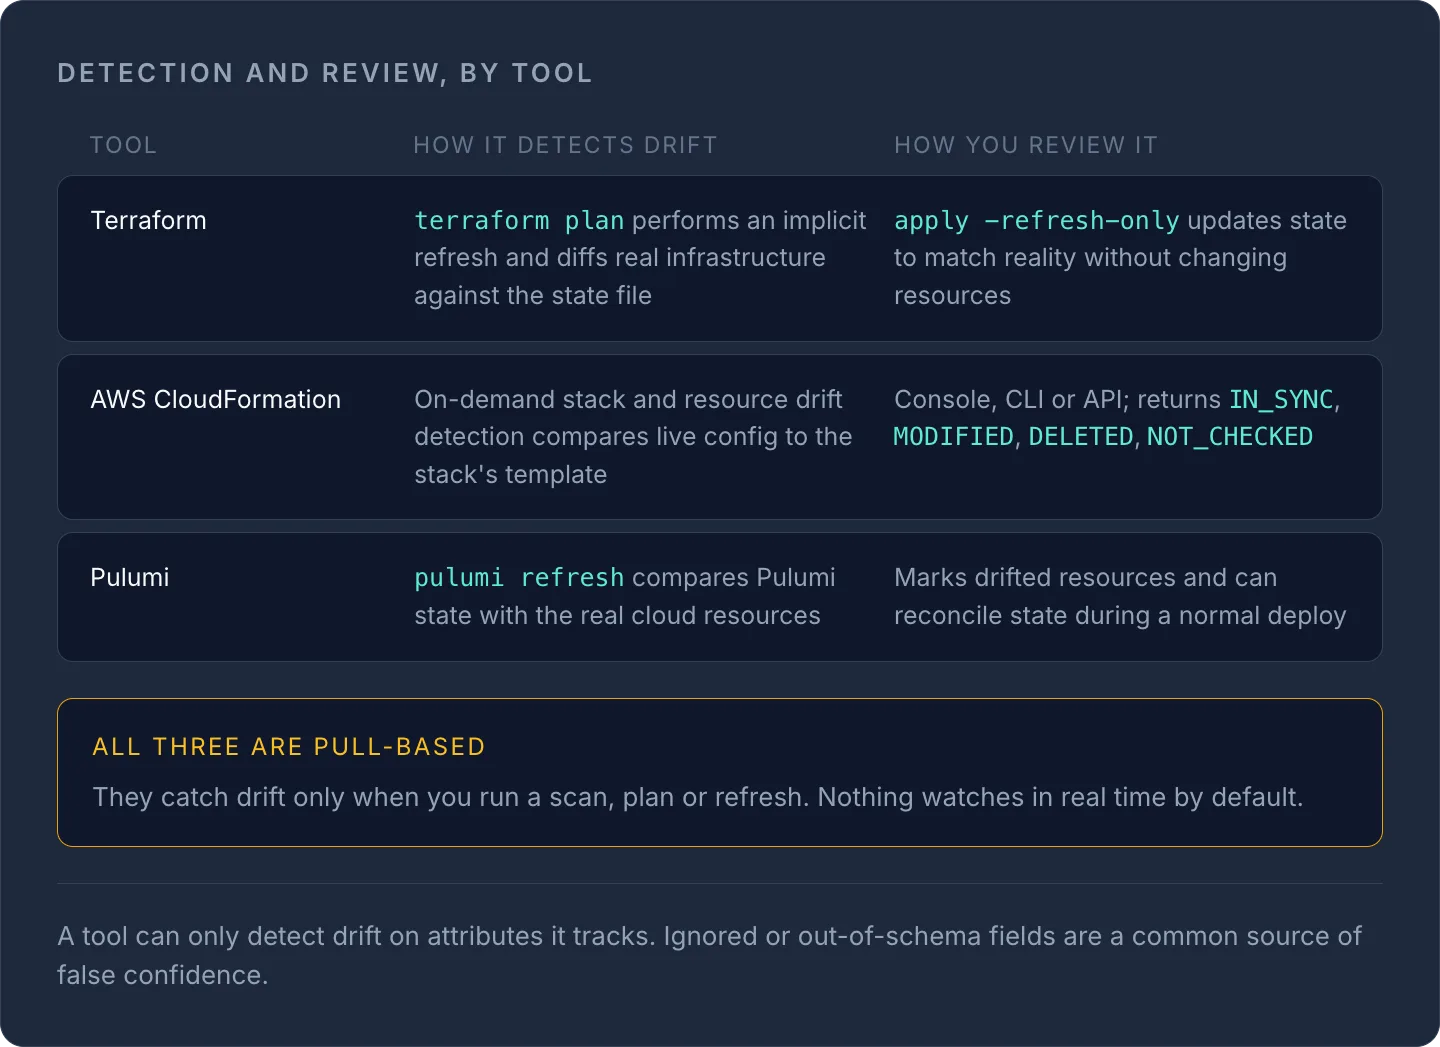
Die meisten IaC-Tools erkennen Drift nach demselben Grundprinzip: Sie fragen über die API des Providers den aktuellen Zustand jeder Ressource ab und vergleichen ihn mit dem zuletzt gespeicherten Zustand. So sieht das bei den wichtigsten Tools aus.
| Tool | Wie es Drift erkennt | Wie du ihn prüfst |
|---|---|---|
| Terraform | terraform plan führt implizit einen Refresh durch, vergleicht die reale Infrastruktur mit der State-Datei und zeigt den Diff an |
terraform apply -refresh-only gleicht den State an die Realität an, ohne Ressourcen zu ändern |
| AWS CloudFormation | Drift-Erkennung auf Stack- bzw. Ressourcenebene auf Abruf vergleicht die Live-Konfiguration mit dem Template des Stacks | Konsole, CLI (detect-stack-drift) oder API; liefert IN_SYNC, MODIFIED, DELETED oder NOT_CHECKED |
| Pulumi | pulumi refresh (oder pulumi up --refresh) vergleicht den Pulumi-State mit den realen Cloud-Ressourcen |
Markiert abweichende Ressourcen und kann den State im Rahmen eines normalen Deployments abgleichen |
NoteAlle drei Ansätze sind Pull-basiert: Sie erkennen Drift nur, wenn du einen Scan, Plan oder Refresh ausführst. Keiner von ihnen überwacht Änderungen standardmäßig in Echtzeit – Drift kann also zwischen zwei Durchläufen stunden- oder tagelang unentdeckt bleiben.
Ein typischer Workflow zur Drift-Prüfung mit Terraform sieht so aus:
# Preview what has drifted, without touching any resources
terraform apply -refresh-only

# If the drift is expected/acceptable, accept the refreshed state
# If it's not, fix the real resource or update your .tf files, then:
terraform plan
terraform apply
Beachte außerdem, dass IaC-Tools Drift nur bei Attributen erkennen können, die sie tatsächlich erfassen. Felder, die über lifecycle { ignore_changes } ausgeschlossen sind oder schlicht außerhalb des Schemas des Tools liegen, erscheinen nicht als Drift, selbst wenn sie sich geändert haben – eine häufige Quelle trügerischer Sicherheit.
Warum DNS besonders anfällig für Drift ist
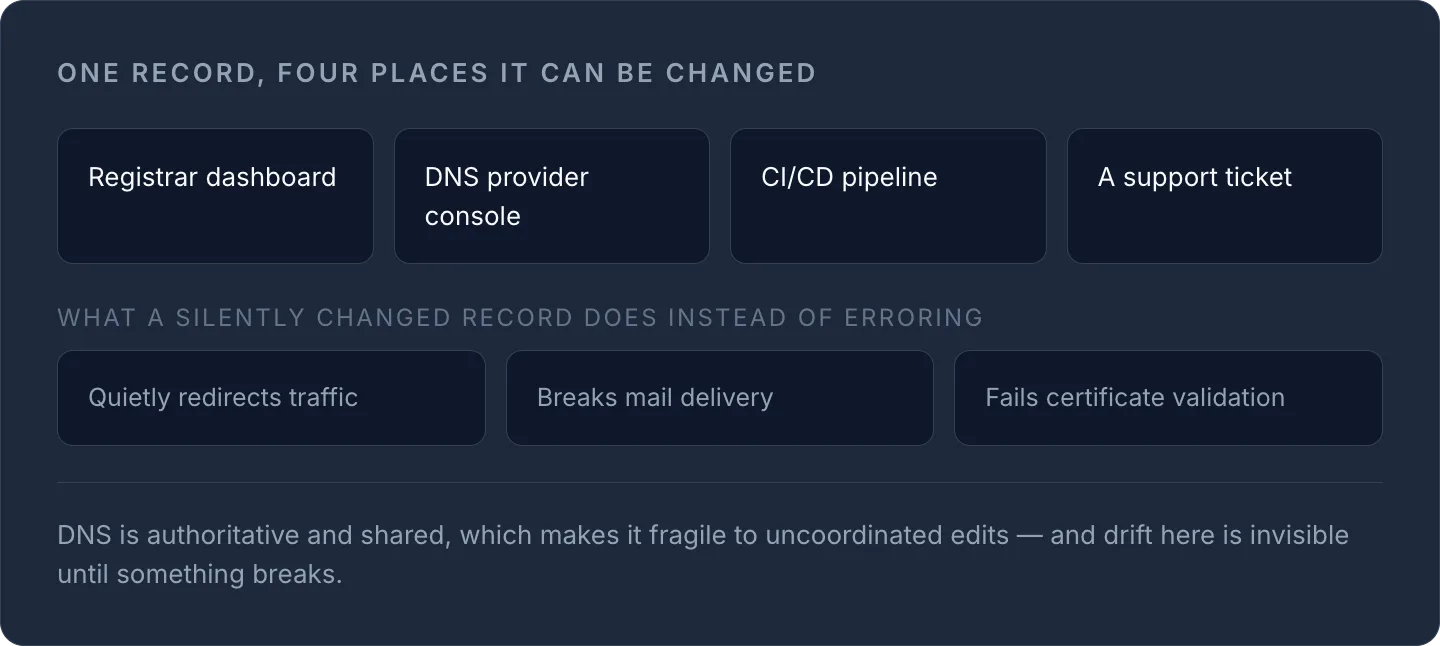
DNS gehört zu den driftanfälligsten Teilen jedes Stacks, und zwar aus einem einfachen Grund: Es lässt sich an zu vielen Stellen bearbeiten. Ein Eintrag kann über das Dashboard deines Registrars, die Konsole deines DNS-Providers, eine CI/CD-Pipeline oder ein Support-Ticket geändert werden – oft von verschiedenen Personen, die nichts von den Änderungen der anderen wissen. Anders als einen Server, auf den du dich per SSH verbinden und den du untersuchen kannst, leitet ein unbemerkt geänderter DNS-Eintrag einfach still Traffic um, stört die Mailzustellung oder lässt eine Zertifikatsvalidierung scheitern – oft ohne eine eindeutige Fehlermeldung.
Genau diese Lücke streift unser Artikel Wie DNS-Auflösung funktioniert von der Seite der Auflösung her – Drift ist dagegen die Change-Management-Seite desselben Problems: DNS ist autoritativ und geteilt, was es anfällig für unkoordinierte Änderungen macht.
Drift-Risiko in der Praxis reduzieren
Du kannst Drift nicht vollständig verhindern – Änderungen auf Provider-Seite und Notfall-Fixes wird es immer geben –, aber du kannst die Auswirkungen begrenzen:
- Zuständigkeit zentralisieren. Lege pro Ressourcentyp ein führendes System fest, besonders für DNS, und leite alle Änderungen darüber.
- Geplante Refresh-/Plan-Jobs ausführen, nicht nur Läufe auf Abruf, damit Drift in einem festen Rhythmus sichtbar wird und nicht nur, wenn jemand daran denkt nachzusehen.
- Bei unerwarteten Änderungen alarmieren, statt sich auf manuelle
plan-Läufe zu verlassen – kontinuierliche, ereignisgesteuerte Erkennung findet Drift viel schneller als periodische Scans. - Ein genaues Inventar führen darüber, was existiert und wem es gehört; in Warum ein Infrastruktur-Inventar wichtig ist erfährst du, was du erfassen solltest.
- Routineänderungen automatisieren, damit es gar nicht erst einen Grund gibt, zur Konsole zu greifen – unser Leitfaden zum Automatisieren von DNS-, SSL- und Server-Aufgaben über Provider hinweg behandelt genau das.
DNS-Drift erkennen, bevor er einen Ausfall verursacht
Weil DNS-Drift unsichtbar bleibt, bis etwas kaputtgeht – ein Mailserver keine Nachrichten mehr empfängt, eine Subdomain plötzlich auf den falschen Host auflöst –, ist kontinuierliche Erkennung am nützlichsten, nicht geplante. Das DNS-Management von InfraNest überwacht deine Zonen bei allen Registrars und Providern über ein einziges Dashboard und meldet unerwartete Änderungen an Einträgen in dem Moment, in dem sie passieren – so musst du dich nicht darauf verlassen, dass jemand daran denkt, einen Diff auszuführen.
Wenn du sehen willst, wie kontinuierliche Drift-Alarmierung in der Praxis aussieht, schau dir das DNS-Management an und finde heraus, wie es sich in deinen restlichen Stack einfügt.
Häufig gestellte Fragen
#Ist Infrastructure Drift dasselbe wie Configuration Drift?
Die Begriffe sind eng verwandt und werden oft synonym verwendet. Configuration Drift bezeichnet meist Server- oder Betriebssystemeinstellungen, die von einer Baseline abweichen, während Infrastructure Drift der umfassendere Begriff ist und jede Ressource – Compute, Netzwerk, DNS – abdeckt, die von ihrem deklarierten Zustand abweicht.
#Kann Drift-Erkennung Ausfälle verhindern?
Drift-Erkennung allein sagt dir nur, dass sich etwas geändert hat; sie verhindert die Änderung nicht. Sie senkt das Ausfallrisiko, indem sie die Zeit zwischen einer unerwünschten Änderung und ihrer Entdeckung verkürzt – besonders in Kombination mit Alarmierung statt manueller, geplanter Prüfungen.
#Verhindert der Einsatz von Terraform oder CloudFormation Drift?
Nein. Diese Tools erkennen Drift, wenn du einen Plan, Refresh oder Drift-Scan ausführst, aber sie können Änderungen außerhalb des regulären Prozesses nicht verhindern und sehen keine Attribute außerhalb ihres erfassten Schemas. Drift ist ebenso ein Prozess- wie ein Tooling-Problem.
#Warum ist DNS-Drift schwerer zu erkennen als Server-Drift?
DNS-Einträge lassen sich meist über mehrere Dashboards, Registrars und Pipelines bearbeiten, ohne eine einzige maßgebliche Quelle, und eine fehlerhafte Änderung erzeugt oft keinen Fehler – nur eine still falsche Auflösung. Deshalb kann sie unbemerkt bleiben, bis Nutzer ein Problem melden.
Mit einem kostenlosen Tool ausprobieren
War dieser Artikel hilfreich?