Synthetic Monitoring ist eine proaktive Testmethode, die nach festem Zeitplan und von definierten Standorten aus skriptbasierte, simulierte Transaktionen gegen deine Website, API oder deinen Server ausführt, um Ausfälle und schlechte Performance zu erkennen, bevor echte Nutzer darauf stoßen. Anders als Monitoring, das auf Live-Traffic angewiesen ist, laufen synthetische Checks unabhängig davon, ob gerade jemand deine Website besucht. Damit sind sie genau das richtige Werkzeug, um Probleme in den Lücken zu finden: um 3 Uhr nachts, in Regionen mit wenig Traffic oder bei einem brandneuen Feature, das noch niemand genutzt hat.
Der Begriff umfasst alles vom einfachen Ping im Minutentakt bis hin zu einer vollständig geskripteten Browser-Session, die sich einloggt, einen Artikel in den Warenkorb legt und den Checkout abschließt – ganz ohne menschliches Zutun.
So funktioniert Synthetic Monitoring
Ein synthetischer Check ist ein Skript, das nach Zeitplan von einem oder mehreren Probe-Standorten aus läuft und protokolliert, was passiert. Im einfachsten Fall ist das ein HTTP-Request an eine URL samt Prüfung, ob Statuscode und Response-Body stimmen. Im komplexesten Fall ist es ein Headless-Browser, der einen mehrseitigen Workflow durchläuft und misst, wie lange jeder Schritt dauert.
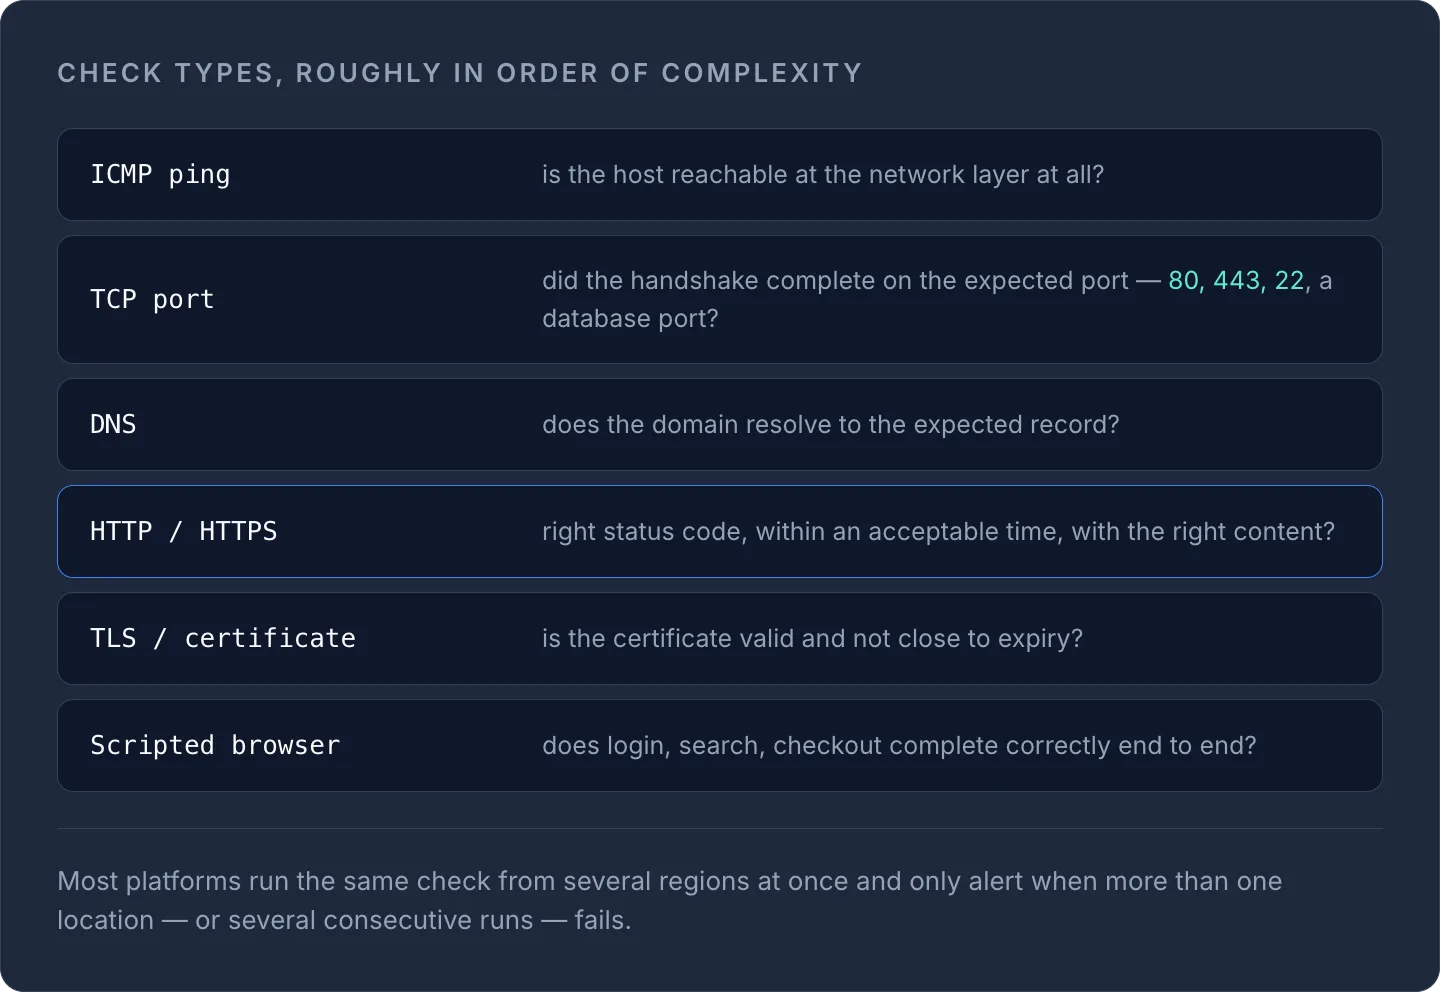
Gängige Check-Typen, grob nach Komplexität geordnet:
- ICMP-Ping – ist der Host auf Netzwerkebene überhaupt erreichbar?
- TCP-Port-Check – wurde der Handshake auf dem erwarteten Port (80, 443, 22, ein Datenbank-Port) abgeschlossen?
- DNS-Check – löst die Domain auf den erwarteten Eintrag auf?
- HTTP/HTTPS-Check – hat der Request den richtigen Statuscode in akzeptabler Zeit und mit dem richtigen Inhalt zurückgegeben?
- TLS-/Zertifikats-Check – ist das Zertifikat gültig und läuft es nicht bald ab?
- Geskriptete Browser-Transaktion – wird eine komplette User Journey (Login, Suche, Checkout) von Anfang bis Ende korrekt durchlaufen?
Unser Leitfaden zu Ping- vs. HTTP- vs. HTTPS-Monitoring geht genauer darauf ein, was jeder einzelne Check-Typ tatsächlich beweist und wo er für sich allein an seine Grenzen stößt.
Die meisten Plattformen führen denselben Check gleichzeitig aus mehreren Regionen aus und lösen erst dann einen Alarm aus, wenn mehr als ein Standort – oder mehrere aufeinanderfolgende Durchläufe – fehlschlagen. Dieses Muster gibt es, weil eine einzelne Probe mit einem kurzzeitigen Problem im eigenen Netzwerk weit häufiger vorkommt als ein tatsächlicher Ausfall deines Dienstes. Die Übereinstimmung mehrerer Standorte zu verlangen, reduziert Fehlalarme um 3 Uhr nachts deutlich.
Synthetic Monitoring vs. Real User Monitoring (RUM)
Die beiden Ansätze beantworten unterschiedliche Fragen, und die meisten ernsthaften Monitoring-Setups nutzen beide.
| Synthetic Monitoring | Real User Monitoring (RUM) | |
|---|---|---|
| Datenquelle | Von dir definierte skriptbasierte Checks | Echte Besucher-Sessions |
| Funktioniert ohne Traffic | Ja | Nein – braucht echte Nutzer |
| Konsistenz | Gleicher Test, gleiche Bedingungen, bei jedem Durchlauf | Variiert je nach Gerät, Netzwerk, Standort |
| Am besten für | Uptime, SLA-Tracking, Tests vor dem Release | Reale Nutzererfahrung, tatsächliche Engpässe |
| Erkennt Probleme, bevor Nutzer sie sehen | Ja | Nein – meldet erst im Nachhinein |
| Einrichtung | Check einmal definieren | Erfordert Traffic + Tracking-Skript |
RUM zeigt dir, was echten Menschen auf echten Geräten tatsächlich passiert ist – hilfreich, um zu verstehen, ob deine langsame mobile Checkout-Seite wirklich Conversions kostet. Synthetic Monitoring zeigt dir, was jedem passieren würde, und zwar jetzt, unter kontrollierten und reproduzierbaren Bedingungen. Genau das brauchst du für Uptime-SLAs, denn du kannst nicht warten, bis ein Kunde das Problem bemerkt.
TipNutze synthetische Checks, um Ausfälle schnell und zuverlässig zu erkennen; nutze RUM (sofern du genug Traffic dafür hast), um die reale Performance-Streuung über Geräte und Regionen hinweg zu verstehen.
Wann solltest du Synthetic Monitoring einsetzen?
Synthetic Monitoring zahlt sich in einigen konkreten Situationen aus:
- Bevor du nennenswerten Traffic hast. Eine neue Website, eine Staging-Umgebung oder ein internes Tool mit wenig Traffic liefert keine RUM-Daten – synthetische Checks sind hier die einzige Option.
- Für SLA- und Uptime-Reporting. Wenn du 99.9% Uptime versprichst, brauchst du eine konsistente, externe Messung – keine Stichprobe des Traffics, der zufällig auf der Website gelandet ist.
- Für kritische, selten genutzte Pfade. Passwort-Reset, Checkout, API-Authentifizierung – Abläufe, die sehr wichtig sind, aber womöglich nicht oft genug aufgerufen werden, damit RUM einen Fehler schnell bemerkt.
- Für Abhängigkeiten und Drittanbieter-Checks. DNS-Auflösung, Zertifikatsablauf, Mail-Routing (MX) – nichts davon taucht in der Browser-Session eines Nutzers auf, aber wenn etwas davon kaputt ist, legt es deinen Dienst trotzdem lahm.
- Für die Validierung über mehrere Regionen. Damit stellst du sicher, dass dein CDN- oder DNS-Setup auch von Sydney aus korrekt auflöst und antwortet – und nicht nur aus deinem Büro in London.
Ein einfacher HTTP-Check im Minutentakt ist für fast jeden öffentlich erreichbaren Dienst eine sinnvolle Basis. Ergänze ihn um TLS-/Zertifikats-Checks und DNS-Checks, denn abgelaufene Zertifikate und fehlerhaftes DNS gehören zu den häufigsten – und am leichtesten vermeidbaren – Ursachen für Ausfälle.
Ein einfaches Beispiel
Eine minimale Konfiguration für einen synthetischen Check eines Login-Endpoints könnte so aussehen:
Check type: HTTPS GET
URL: https://app.example.com/api/health
Expected status: 200
Expected body contains: "status":"ok"
Timeout: 10s
Interval: 1 minute
Locations: London, Frankfurt, N. Virginia, Singapore
Alert if: fails from 2+ locations, or fails 3 consecutive times
Dieser eine Check erkennt einen abgestürzten Prozess, ein fehlerhaftes Deployment, eine DNS-Fehlkonfiguration oder ein Zertifikat, das über Nacht unbemerkt abgelaufen ist – ohne dass du warten musst, bis ein Kunde ein Support-Ticket eröffnet.
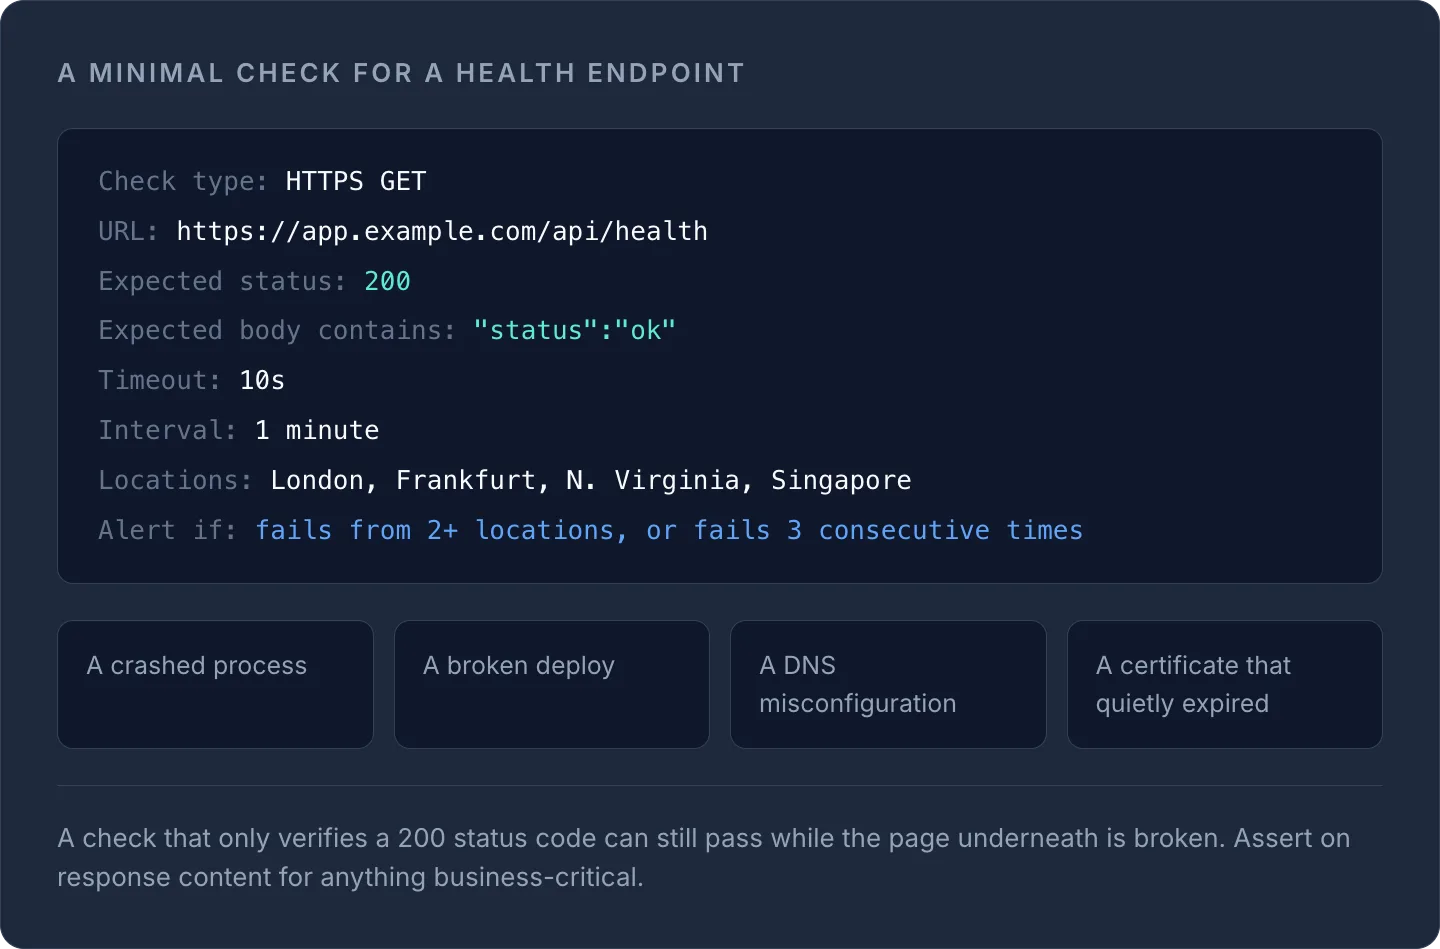
WarningEin Check, der nur einen 200-Statuscode prüft, kann weiterhin erfolgreich sein, obwohl die Seite dahinter kaputt ist. Prüfe bei allem Geschäftskritischen den tatsächlichen Inhalt der Response, nicht nur den Statuscode.
So ergänzt Synthetic Monitoring deine anderen Checks
Synthetic Monitoring ist eine Ebene eines umfassenderen Observability-Stacks, kein Ersatz für die anderen. Es lässt sich hervorragend mit der Überwachung von Zertifikatsabläufen, DNS-Health-Checks und Alarmen bei Infrastrukturänderungen kombinieren. Unser Beitrag Website-Monitoring erklärt zeigt, wie Uptime-, Performance- und SSL-Checks zusammenspielen, und Erkennung von Infrastructure Drift behandelt, wie du unerwartete Konfigurationsänderungen aufspürst, die synthetische Checks allein übersehen könnten.
Das Monitoring von InfraNest führt geplante synthetische HTTP-, TCP- und SSL-Checks für deine Domains und Server über ein zentrales Dashboard aus – direkt neben deinem DNS- und Zertifikatsmanagement. So kann dir derselbe Ort, der dir einen fehlgeschlagenen Check meldet, auch sagen, ob eine DNS-Änderung oder ein ablaufendes Zertifikat die Ursache war.
Häufig gestellte Fragen
#Ist Synthetic Monitoring dasselbe wie Uptime Monitoring?
Uptime Monitoring ist ein häufiger Anwendungsfall von Synthetic Monitoring, aber Synthetic Monitoring ist die umfassendere Methode – sie umfasst auch geskriptete Transaktionstests, DNS-Checks und Checks auf Zertifikatsablauf, nicht nur die Frage „Ist die Website erreichbar?“.
#Wie oft sollten synthetische Checks laufen?
Ein einfacher HTTP- oder Ping-Check alle 1-5 Minuten ist für die meisten öffentlich erreichbaren Dienste eine sinnvolle Basis; geskriptete mehrstufige Browser-Checks laufen meist seltener, etwa alle 5-15 Minuten, da sie pro Durchlauf mehr Ressourcen benötigen.
#Kann Synthetic Monitoring Real User Monitoring komplett ersetzen?
Nein – Synthetic Monitoring zeigt dir, was unter kontrollierten Bedingungen passieren würde, während RUM zeigt, was echten Besuchern auf echten Geräten tatsächlich passiert ist; die meisten Produktiv-Setups profitieren von beidem.
#Müssen synthetische Checks von mehreren Standorten aus laufen?
Wenn du denselben Check aus mehreren Regionen ausführst, kannst du einen echten Ausfall von einem lokalen Netzwerkproblem einer einzelnen Probe unterscheiden; die meisten Plattformen schlagen erst Alarm, wenn mehrere Standorte übereinstimmend einen Fehlschlag melden.
Mit einem kostenlosen Tool ausprobieren
War dieser Artikel hilfreich?