Infrastructure Drift ist jede Abweichung zwischen dem, was laut deiner Konfiguration existieren sollte, und dem, was tatsächlich läuft. Die Lösung besteht nicht darin, jede manuelle Änderung zu verhindern, sondern Drift schnell zu erkennen, bevor daraus ein Ausfall oder eine Sicherheitslücke wird. Dafür brauchst du Drift Detection in Kombination mit echtem Alerting, nicht nur ein Dashboard, an das du denken musst.
Drift kommt häufiger vor, als die meisten Teams zugeben. Jemand bearbeitet an einem Freitag einen A-Eintrag direkt in der Konsole des Registrars, um ein Deployment freizubekommen. Ein externer Dienstleister fügt während eines Incidents eine Firewall-Regel hinzu und vergisst, sie zu dokumentieren. Ein Cloud-Anbieter migriert eine Ressource automatisch und ändert dabei stillschweigend ihre IP. Nichts davon taucht in deiner Git-Historie auf, und nichts davon löst ein Pull-Request-Review aus. Die Änderungen bleiben einfach bestehen, bis etwas kaputtgeht.
Was ist Infrastructure Drift genau?
Drift ist der Unterschied zwischen deinem deklarierten Zustand (einer Terraform-Datei, einem DNS-Zonenexport, einem CloudFormation-Template) und dem Live-Zustand der tatsächlichen Ressource. Infrastructure-as-Code-Tools (IaC) wie Terraform und Pulumi erkennen Drift, indem sie die reale Ressource erneut auslesen und mit der zuletzt bekannten State-Datei vergleichen. terraform plan -refresh-only und pulumi refresh gibt es genau dafür: Sie zeigen, was sich in der Realität geändert hat, ohne vorzuschlagen, es wieder zu überschreiben.
DNS-Drift ist ein besonderer Fall dieses Problems mit hohem Risiko. Deine Zonendatei, dein IaC-Repo oder deine Ticket-Historie sagt, ein Eintrag soll auf ein bestimmtes Ziel zeigen, aber der autoritative Nameserver liefert etwas anderes. Da DNS vor fast allem sitzt (Mail, Website, API-Endpunkte, SPF/DKIM-Alignment), ist ein abweichender Eintrag selten nur kosmetisch. Meist ist er das erste Symptom eines größeren Problems: ein kompromittiertes Registrar-Konto, ein vergessener Migrationsschritt oder ein gut gemeinter Workaround eines Engineers, der eine kaputte Pipeline umgeht, statt sie zu reparieren.
Warum gerade Out-of-Band-Änderungen wehtun
Jede Änderung über deine IaC-Pipeline wird geprüft, protokolliert und ist rückgängig zu machen. Out-of-Band-Änderungen, also direkt in einer Anbieterkonsole, einem Registrar-Dashboard oder per Support-Ticket vorgenommene Änderungen, überspringen all das. Sie bleiben unsichtbar, bis jemand das Symptom bemerkt (zurückgewiesene Mails, ein Zertifikatsfehler, eine Subdomain, die auf ein unerwartetes Ziel auflöst).
WarningEin geänderter MX- oder CNAME-Eintrag kann in deinem Repo völlig korrekt aussehen und in der Produktion trotzdem falsch sein, denn der DNS-Zustand liegt beim Registrar oder DNS-Hoster, nicht in deinem Code. Wenn du immer nur deine Source of Truth prüfst, wirst du Drift, der nachgelagert entsteht, nie sehen.
Typische Out-of-Band-Drift-Szenarien, auf die du achten solltest:
- Eine TTL (Time to Live), die während eines Incidents stillschweigend verlängert und nie zurückgesetzt wurde und deine nächste legitime Änderung verlangsamt.
- Ein CNAME- oder A-Eintrag, der von einer Drittanbieter-Integration (einem CDN, einer E-Mail-Plattform) umgeleitet wurde, ohne dass deine Zonendokumentation entsprechend aktualisiert wurde.
- Ein SPF- oder DKIM-TXT-Eintrag, den ein Marketing-Tool bearbeitet hat, wodurch das Alignment unbemerkt bricht und die Zustellbarkeit leidet.
- Eine Subdomain, die nach der Abschaltung eines Dienstes übrig geblieben ist und jetzt anfällig für Subdomain Takeover ist.
- Ein Zertifikat, das bei einem anderen Anbieter neu ausgestellt wurde und damit die Zertifikatskette ändert, die dein Monitoring erwartet.
Zur Auffrischung, was die einzelnen Eintragstypen eigentlich steuern, wirf einen Blick in den kompletten Leitfaden zu DNS-Eintragstypen.
Wie Drift Detection funktioniert
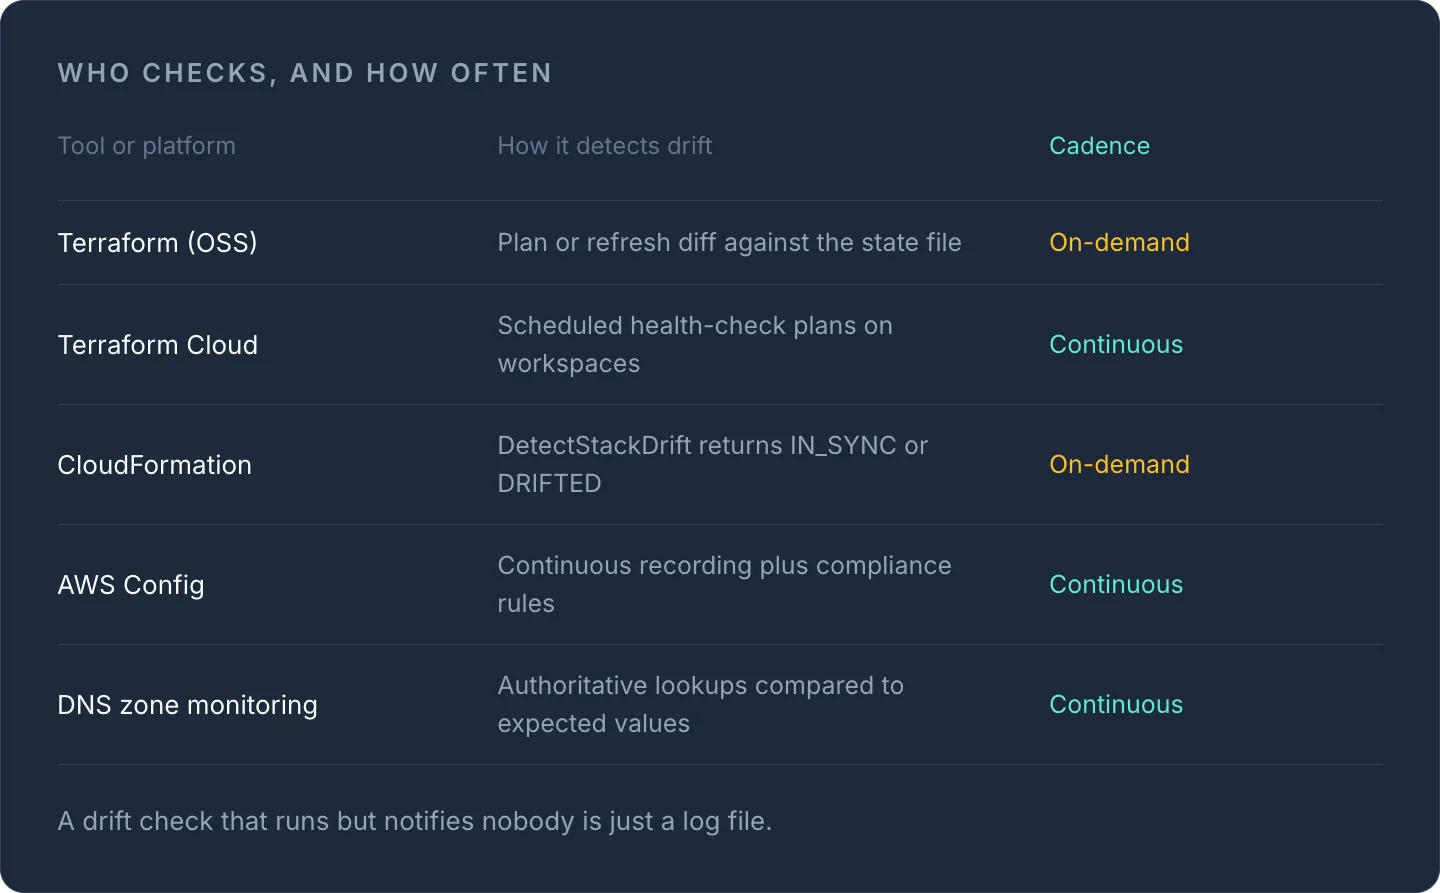
Die meisten Verfahren zur Drift Detection folgen derselben Grundschleife, egal ob sie auf einen Cloud-Stack oder eine DNS-Zone angewendet werden: den aktuellen Soll-Zustand erfassen, den Live-Zustand regelmäßig erneut auslesen, beide vergleichen und bei jeder Abweichung alarmieren. Die Details unterscheiden sich je nach Plattform:
| Tool/Plattform | Wie Drift erkannt wird | Kontinuierlich oder bei Bedarf? |
|---|---|---|
| Terraform (OSS) | plan/refresh-Diff gegen die State-Datei |
Bei Bedarf, manuell oder per Zeitplan ausgeführt |
| Terraform Cloud/Enterprise | Geplante Health-Check-Plans für Workspaces | Kontinuierlich (kostenpflichtiger Tarif) |
| AWS CloudFormation | DetectStackDrift-API, liefert IN_SYNC / DRIFTED / NOT_CHECKED |
Bei Bedarf (für Zeitpläne sind EventBridge + Lambda nötig) |
| AWS Config | Kontinuierliche Aufzeichnung + Compliance-Regeln, verknüpft mit SNS/EventBridge | Kontinuierlich |
| DNS-Zonen-Monitoring | Regelmäßige autoritative Abfragen, verglichen mit erwarteten Werten | Kontinuierlich, abhängig vom Anbieter |
Was in der Produktion tatsächlich Probleme aufdeckt, ist kontinuierliches Polling plus Push-Alerting, nicht ein Bericht, den du einmal pro Woche aufrufst. Ein Drift-Check, der läuft, aber niemanden benachrichtigt, ist nur eine Logdatei.
DNS-Änderungen überwachen: Drift-Alerts in der Praxis einrichten
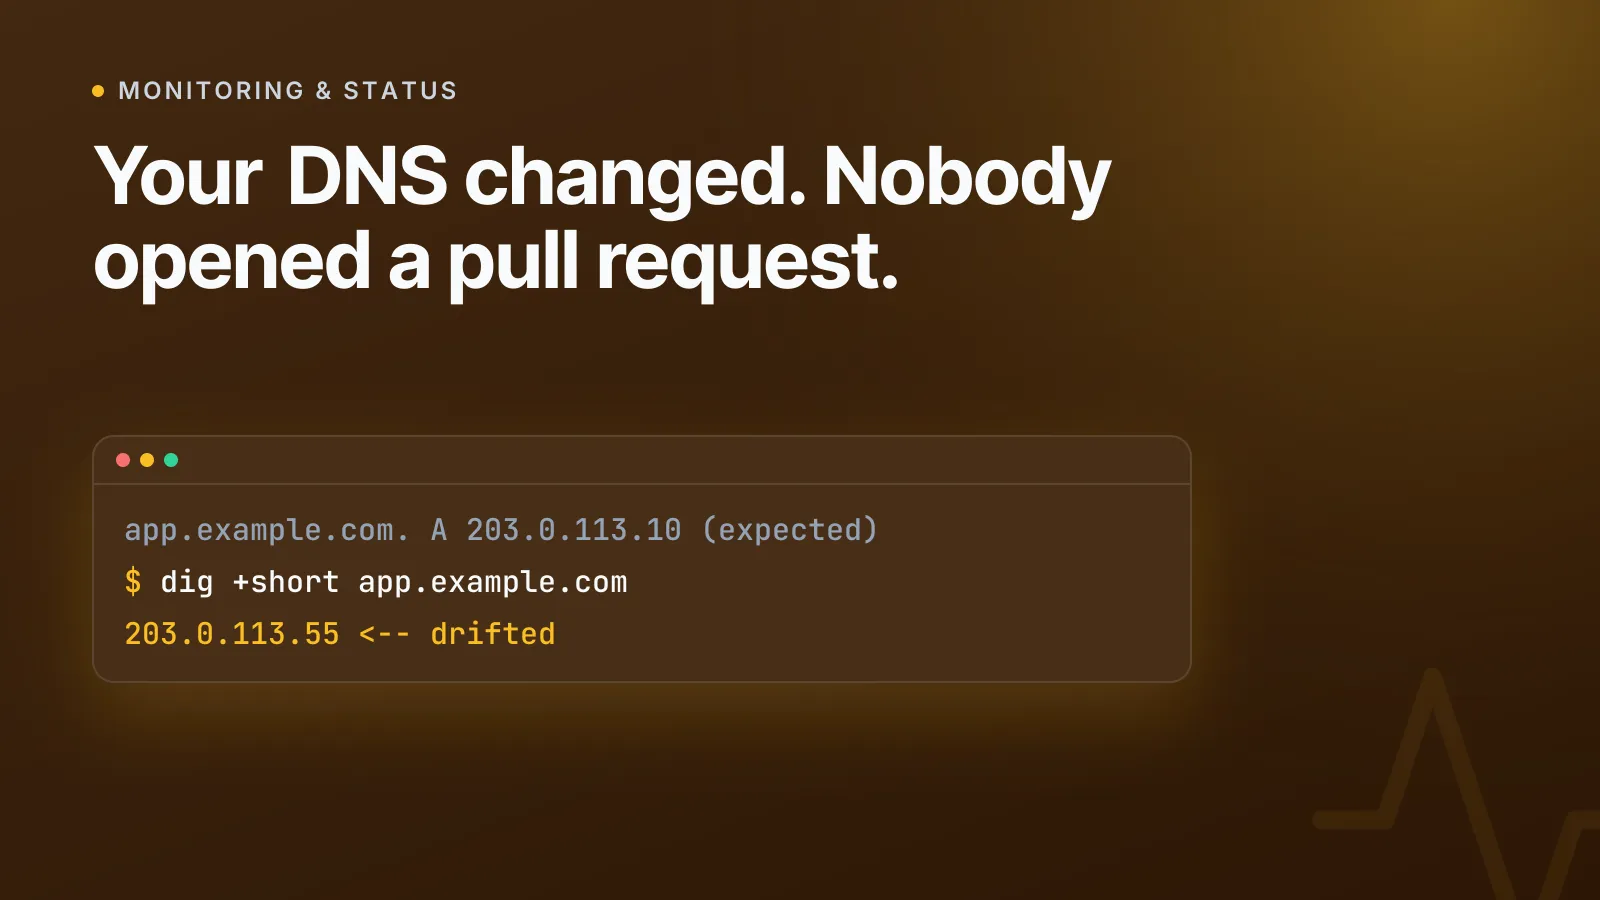
Du brauchst keine vollständige IaC-Pipeline, um DNS-Drift zu erkennen. Lege mindestens fest, worauf jeder Eintrag auflösen soll, und vergleiche das regelmäßig mit dem, worauf er tatsächlich auflöst:
# Expected state (your source of truth)
app.example.com.    A      203.0.113.10
mail.example.com.   MX     10 mail.example.com.
example.com.        TXT    "v=spf1 include:_spf.example.com ~all"

# Observed state (queried live)
app.example.com.    A      203.0.113.55   <-- drifted
Einzelne Einträge kannst du sofort mit dem kostenlosen DNS-Lookup-Tool stichprobenartig prüfen. Das ist praktisch, um einen vermuteten Drift zu bestätigen, bevor du eskalierst. Für dauerhaften Schutz sollte dieser Vergleich aber kontinuierlich laufen und einen Alert auslösen, sobald sich ein Wert ändert, statt darauf zu setzen, dass jemand an die Prüfung denkt.
Genau das leistet das DNS-Management von InfraNest über alle Registrare und DNS-Hoster hinweg, die du nutzt: Es verfolgt den erwarteten Wert jedes Eintrags und schlägt Alarm, sobald die Live-Antwort abweicht, statt auf ein Support-Ticket zu warten. Kombiniere das mit Uptime- und Infrastruktur-Monitoring, damit ein abweichender Eintrag, der tatsächlich etwas kaputt macht (ein toter A-Eintrag, ein Mailserver, der keine Verbindungen mehr annimmt), einen zweiten, unabhängigen Alert auslöst, der auf realen Auswirkungen basiert und nicht nur auf dem Konfigurationszustand.
TipAlarmiere bei der Änderung, nicht erst beim Ausfall. Ein Eintrag, der stillschweigend auf eine unbekannte IP umgeleitet wird, verdient eine Untersuchung, auch wenn die Website noch lädt. Er könnte über einen fremden Proxy oder im Zuge eines Takeover-Versuchs auflösen statt über deinen echten Server.
Was tun, wenn ein Drift-Alert auslöst?
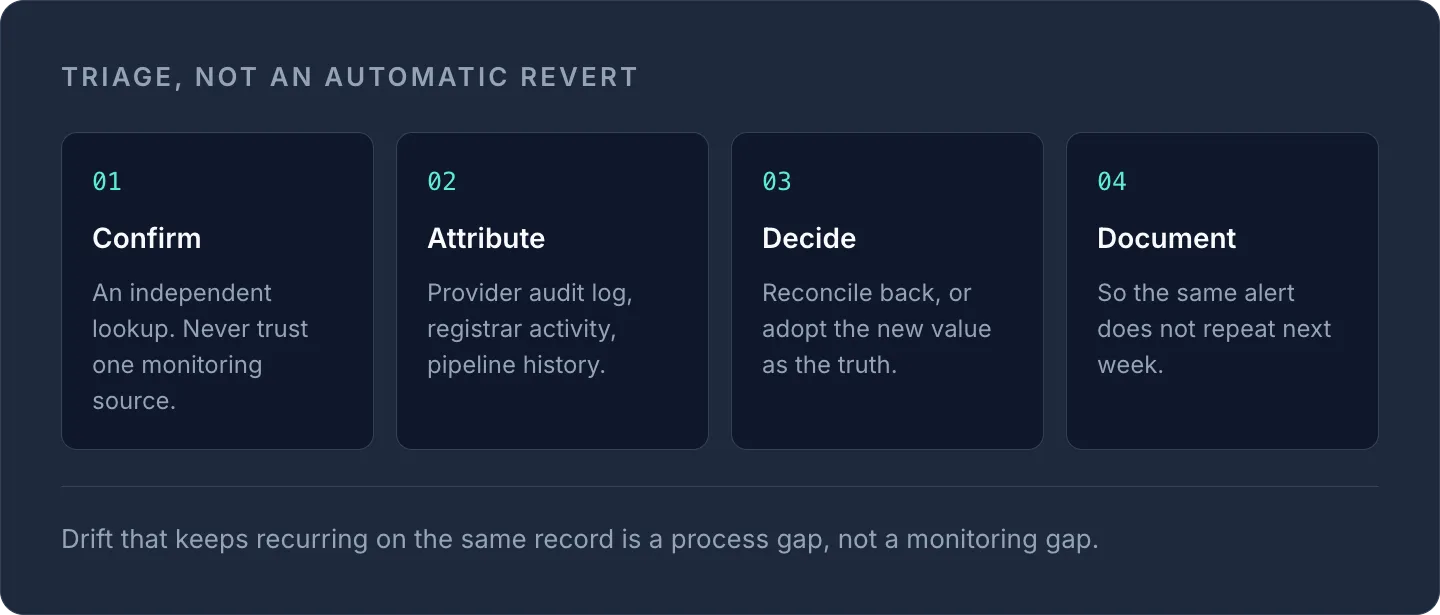
Behandle jeden Drift-Alert als Triage-Frage, nicht als automatisches Zurücksetzen:
- Bestätige mit einer unabhängigen Abfrage, dass die Änderung real ist (verlass dich nicht auf eine einzige Monitoring-Quelle).
- Prüfe, wer oder was die Änderung vorgenommen hat: Audit-Log des Anbieters, Aktivitätsprotokoll des Registrars oder Historie der IaC-Pipeline.
- Entscheide, ob du auf den deklarierten Zustand zurücksetzt oder den neuen Wert als neue Source of Truth übernimmst.
- Dokumentiere die Entscheidung, damit derselbe Alert nicht nächste Woche wieder auftaucht.
Wenn bei demselben Eintrag immer wieder Drift auftritt, ist das meist eine Prozesslücke, keine Monitoring-Lücke: Irgendetwas (ein Skript, eine Integration, eine Person) hat einen dauerhaften Grund, deinen normalen Änderungsweg zu umgehen. Es lohnt sich herauszufinden, was das ist, bevor du weiter Symptome bekämpfst. Wenn dein Team das über mehrere Clouds und Registrare hinweg verwaltet, lies auch, wie du DNS-, SSL- und Server-Aufgaben über alle Anbieter hinweg automatisierst, damit von vornherein weniger Änderungen manuell erfolgen müssen.
Erste Schritte
Drift Detection lohnt sich nur, wenn sie mit einem Alert kombiniert ist, der auch wirklich jemanden erreicht. Richte DNS-Monitoring für deine kritischen Zonen ein und ergänze es um Uptime Monitoring. So erkennst du sowohl die Konfigurationsänderung als auch den Ausfall, den sie verursacht, je nachdem, was zuerst bemerkt wird.
Häufig gestellte Fragen
#Was ist der Unterschied zwischen Drift Detection und Monitoring?
Drift Detection vergleicht deine deklarierte Konfiguration (eine DNS-Zone, eine IaC-State-Datei) mit der Live-Ressource, um nicht autorisierte Änderungen zu erkennen. Monitoring prüft dagegen, ob ein Dienst tatsächlich erreichbar ist und antwortet. Du brauchst beides: Drift Detection erkennt die Ursache, Monitoring die Auswirkung.
#Kann DNS-Drift auftreten, auch wenn ich meine Zonendatei nie anfasse?
Ja. Drittanbieter-Integrationen, CDNs, E-Mail-Plattformen und sogar der Registrar selbst können einen Eintrag außerhalb deines normalen Änderungsprozesses ändern. Die Zone kann also abweichen, ohne dass jemand aus deinem Team etwas bearbeitet hat.
#Wie oft sollten DNS-Einträge auf Drift geprüft werden?
Kontinuierliche Prüfung ist Best Practice für alles, was kundenrelevant ist, denn ein abweichender MX- oder A-Eintrag kann die Mailzustellung oder die Verfügbarkeit innerhalb von Minuten beeinträchtigen. Wenn eine kontinuierliche Prüfung nicht möglich ist, prüfe besonders wichtige Einträge (Root-A/AAAA, MX, SPF/DKIM-TXT) mindestens täglich.
#Funktioniert Drift Detection bei Cloud-Servern genauso wie bei DNS?
Das Grundprinzip ist identisch: deklarierten Zustand mit dem Live-Zustand vergleichen und bei Abweichungen alarmieren. Die Mechanik unterscheidet sich jedoch. Cloud-Drift-Detection nutzt typischerweise Anbieter-APIs wie DetectStackDrift von AWS oder den Refresh von Terraform, während DNS-Drift-Detection auf autoritativen Live-Abfragen basiert, die mit den erwarteten Eintragswerten verglichen werden.
Mit einem kostenlosen Tool ausprobieren
War dieser Artikel hilfreich?