De taak van een load balancer is beperkt: hij verdeelt binnenkomend verkeer over meerdere backendservers, controleert welke daarvan gezond zijn en leidt het verkeer om de servers heen die dat niet zijn. Draai je maar één server, dan voegt een load balancer een extra netwerkhop, een kostenpost en een nieuw faalpunt toe zonder iets te verdelen. Wat je dan nodig hebt, is een reverse proxy, geen load balancer.
Dat onderscheid raakt vaak zoek, omdat "load balancer" een verzamelterm is geworden voor "het ding vóór mijn app", zelfs in opstellingen met één server waar er niets te balanceren valt. Wie de twee taken van een load balancer begrijpt, health checks en verkeersverdeling, ziet meteen wanneer je er een nodig hebt en wanneer je betaalt voor een functie die je niet kunt gebruiken.
Wat een load balancer eigenlijk doet
Haal de marketing weg en een load balancer doet twee dingen: hij bepaalt welke backend elk request krijgt, en hij bepaalt of een backend überhaupt requests mag ontvangen. Al het andere, zoals TLS-terminatie, sticky sessions en routering op basis van het pad, bouwt voort op die twee taken.
Load balancers werken op een van twee lagen:
- Layer 4 (transport): werkt alleen met IP- en TCP/UDP-headers. Hij stuurt pakketten door op basis van IP en poort, zonder zicht op de HTTP-inhoud. De Network Load Balancer van AWS en de Load Balancer van Azure zijn allebei strikt L4.
- Layer 7 (applicatie): termineert de verbinding, parset HTTP (of gRPC/WebSocket) en routeert op host, pad, headers of cookies. De Application Load Balancer van AWS en de HTTP(S) load balancer van GCP werken zo.
| Layer 4 | Layer 7 | |
|---|---|---|
| Ziet | IP + poort | Volledig HTTP-request |
| Kan routeren op pad/host | Nee | Ja |
| Termineert TLS | Alleen passthrough | Ja |
| Behoudt client-IP | Standaard (of via PROXY protocol) | Via X-Forwarded-For- / Forwarded-header |
| Typisch gebruik | Ruwe TCP, hoge doorvoer, niet-HTTP-protocollen | Webapps, API's, microservices |
De rij over het client-IP is belangrijker dan ze lijkt. Een L4-load balancer die TCP termineert, moet de backend nog steeds laten weten wie de echte client was; daarvoor dient het door HAProxy onderhouden PROXY protocol. Een L7-load balancer voegt in plaats daarvan headers toe: X-Forwarded-For is de informele conventie die iedereen net iets anders implementeert, terwijl RFC 7239 een gestandaardiseerde Forwarded-header definieert die minder tools daadwerkelijk gebruiken. Logt je app het IP van de load balancer in plaats van dat van de bezoeker, dan is dit vrijwel altijd de reden.
Health checks: hoe een load balancer weet dat een server down is
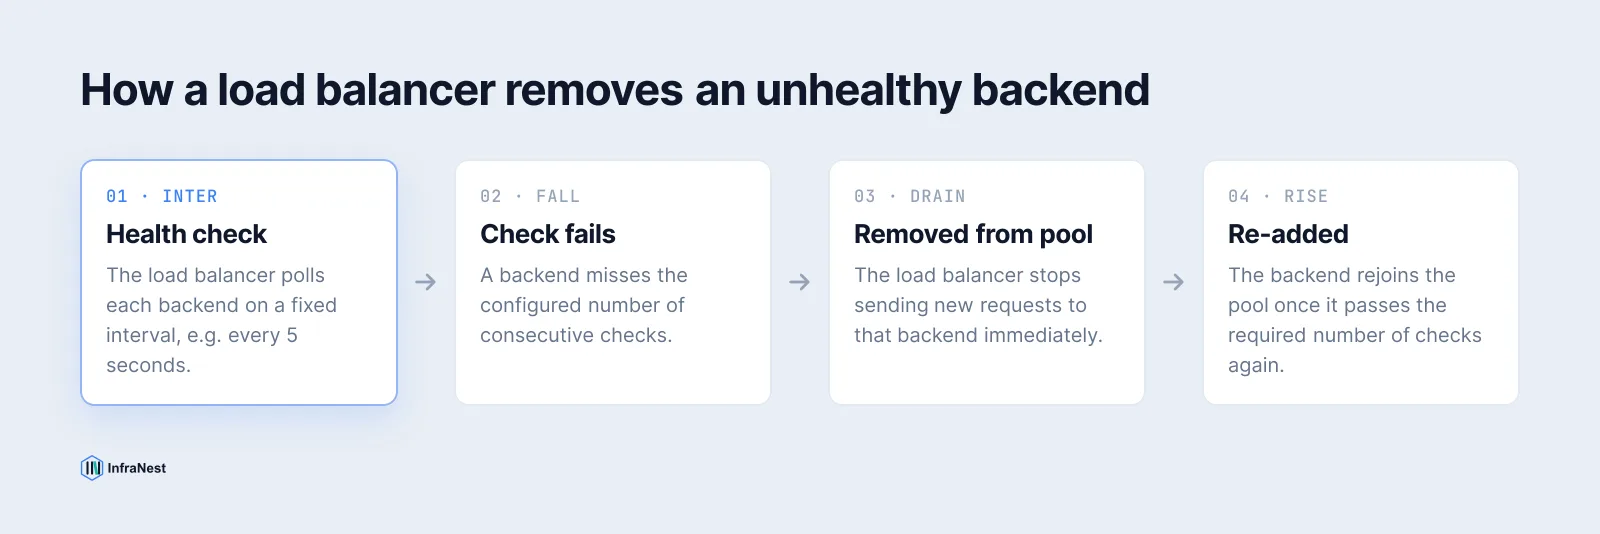
Een load balancer die een dode backend niet kan detecteren, is gewoon een verkeerssplitser; de health check maakt hem veerkrachtig. Hij pollt elke backend met een vast interval, en zodra een backend genoeg opeenvolgende checks niet doorstaat, wordt die direct uit de rotatie gehaald: geen DNS-wijziging, geen handmatige ingreep en geen verkeer naar een server die het niet kan afhandelen.
Hier is een werkend HAProxy-voorbeeld. option httpchk voert een HTTP-health check uit, en fall/rise bepalen na hoeveel opeenvolgende checks de status van een backend omslaat:
backend web_servers
 balance roundrobin
 option httpchk GET /healthz
 http-check expect status 200
 server web1 10.0.0.11:80 check inter 5s fall 3 rise 2
 server web2 10.0.0.12:80 check inter 5s fall 3 rise 2
inter 5s pollt elke 5 seconden, fall 3 haalt een gezonde server eruit na 3 mislukkingen, rise 2 zet hem terug na 2 geslaagde checks. De managed load balancers van AWS werken onder de motorkap op dezelfde manier, alleen configureer je ze via de console of API in plaats van een configuratiebestand.
TipEen health check-endpoint moet controleren of de app echt verkeer kan afhandelen (databaseconnectiviteit, bereikbaarheid van de cache) en niet alleen of het proces draait. Een
/healthzdie altijd200 OKteruggeeft, slaat de plank volledig mis.
Hier lopen load balancing en uptime monitoring ook uiteen: een health check houdt slecht verkeer weg bij één backend in een pool, terwijl externe monitoring je vertelt dat de hele dienst down is. Meestal wil je allebei; zie onze gids over websitemonitoring voor dat laatste.
Sessiebeheer en waarom sticky sessions een workaround zijn
Load balancers verdelen requests, maar veel apps slaan sessiestatus, zoals een winkelwagen of een login, op in het lokale geheugen van de server. Stuur je het tweede request naar een andere backend dan het eerste, dan is die status weg.
Sticky sessions (sessieaffiniteit) lossen dit op door een client voor de duur van een sessie aan één backend te koppelen, meestal via een cookie die de load balancer instelt en bij elk request uitleest, of door het IP van de client te hashen naar een vaste backend. Het is goed om nuchter te zijn over wat dit is: een workaround voor een stateful app, geen load balancing-functie. Bovendien ondermijnt het ongemerkt het doel van load balancing voor die client, want al diens verkeer gaat nu naar één server, ongeacht de belasting.
De betere oplossing op de lange termijn is de app stateless maken: sla sessies op in een gedeelde store (Redis, een database) die elke backend kan lezen, zodat de load balancer puur op belasting kan routeren en niet op geschiedenis. Zit je voorlopig vast aan sticky sessions, dan is dat een legitieme noodoplossing; zie het alleen niet als eindstation.
Load balancing-algoritmes in het kort
De meeste load balancers gebruiken standaard round robin, en dat is prima tot het verkeer of de specificaties van de backends ongelijk worden. De gangbare opties:
- Round robin: requests gaan om de beurt naar elke backend, zonder rekening te houden met de belasting. De standaard van Nginx en HAProxy.
- Weighted round robin: hetzelfde, maar grotere servers krijgen een evenredig groter aandeel.
- Least connections: nieuwe requests gaan naar de backend met de minste actieve verbindingen.
- IP hash / consistent hashing: het IP van een client wordt gehasht naar een specifieke backend, wat sessieaffiniteit geeft zonder centrale sessiestore.
Voor de meeste HTTP-workloads gaat least connections (of "least outstanding requests" van AWS ALB) beter om met ongelijke requestduur dan round robin, omdat round robin niet weet of het hem iets kan schelen dat één backend nog bezig is met een traag request.
Wanneer je geen load balancer nodig hebt
Het geval met één server is het duidelijkst: een load balancer vóór precies één backend voegt latency, kosten en een nieuw faalpunt toe, terwijl hij niets verdeelt. Wat je daar eigenlijk wilt, is een reverse proxy (Nginx, Caddy) voor TLS-terminatie en eventueel eenvoudige rate limiting; de verdeelhelft van een load balancer heeft simpelweg niets te doen.```
Nog een paar situaties waarin een aparte load balancer niet de juiste laag is:
- DNS round robin kan verkeer over meerdere A/AAAA-records spreiden zonder enige load balancer-laag. Het heeft echter geen actieve health checks en is onderhevig aan caching door resolvers en clients voorbij de TTL, dus failover is traag en ongelijkmatig, niet direct. Zie onze gids over DNS-propagatie voor de oorzaak van die vertraging.
- Clustering op procesniveau (de
cluster-module van Node, meerdere systemd-service-instanties achter één socket) verdeelt de belasting over CPU-cores op één host, zonder netwerkhop. - Kubernetes
ClusterIP-services verdelen de belasting tussen pods al intern viakube-proxy. Je hebt alleen een extern load balancer-object nodig als verkeer van buitenaf het cluster in moet. - CDN's en edge-netwerken verzorgen al geografische, anycast-gebaseerde verdeling voor statische en cachebare content; een regionale load balancer vóór dat soort verkeer is overbodig.
Het patroon in al deze gevallen: als iets anders het verkeer al verdeelt of er maar één plek is waar het heen kan, is een load balancer pure overhead. Voeg er een toe wanneer je een tweede backend toevoegt die echt, niet-cachebaar verkeer moet delen, niet eerder.
Een load balancer kiezen
Kies je tussen de opties van providers, stem de laag dan af op het protocol: L4 (AWS NLB, Azure Load Balancer) voor ruwe TCP/UDP of wanneer je het client-IP wilt behouden zonder headers te herschrijven; L7 (AWS ALB, GCP HTTP(S) LB) voor alles wat op HTTP is gebaseerd en routering op pad of host nodig heeft. Vergelijk je providers breder, dan laat onze vergelijking Hetzner vs DigitalOcean vs AWS naast elkaar zien hoe elk van hen load balancing en servers aanpakt.
NoteIdle timeouts zijn belangrijker dan mensen verwachten: AWS ALB hanteert standaard een idle timeout van 60 seconden en sluit verbindingen waarbij de client langer stil blijft. Backends met long polling of SSE moeten deze waarde vaak expliciet verhogen.
De configuratie van je load balancer beheren naast de servers erachter gaat makkelijker als beide op dezelfde plek staan. Met het cloudserverbeheer van InfraNest richt je servers bij verschillende providers in, monitor je ze en automatiseer je ze vanuit één dashboard, in plaats van met de console van elke cloud apart te jongleren.
Veelgestelde vragen
#Voegt een load balancer latency toe?
Ja, een load balancer voegt een netwerkhop toe en, bij Layer 7-load balancers, de kosten van het termineren en opnieuw opzetten van de verbinding. In de praktijk gaat het meestal om een paar milliseconden, weinig vergeleken met de verwerkingstijd van de backend, maar het is niet nul.
#Wat is het verschil tussen een load balancer en een reverse proxy?
Een reverse proxy staat vóór een of meer backends en kan TLS-terminatie, caching en routering afhandelen; een load balancer is een reverse proxy die gespecialiseerd is in het verdelen van verkeer over meerdere backends. Tools als Nginx en HAProxy kunnen beide taken tegelijk uitvoeren.
#Heb ik sticky sessions nodig als mijn app stateless is?
Nee. Sticky sessions bestaan om apps te ondersteunen die sessiestatus lokaal op één server opslaan. Leest je app sessies uit een gedeelde store zoals Redis, dan kan elke backend elk request afhandelen en is affiniteit niet nodig.
#Kan ik de belasting verdelen zonder apart load balancer-product?
Ja. DNS round robin, de ingebouwde balancering van ClusterIP-services in Kubernetes en clustering op procesniveau op één host kunnen allemaal de belasting verdelen zonder aparte load balancer-laag, al leveren ze elk actieve health checks of verdeling over meerdere hosts in.
Probeer het met een gratis tool
Was dit artikel nuttig?