Le rôle d'un load balancer est précis : il répartit le trafic entrant entre plusieurs serveurs backend, vérifie lesquels sont en bonne santé et contourne ceux qui ne le sont pas. Si vous n'exploitez qu'un seul serveur, un load balancer ajoute un saut réseau, une ligne de coût et un nouveau point de défaillance sans rien répartir du tout. Ce qu'il vous faut, c'est un reverse proxy, pas un load balancer.
Cette distinction se perd parce que « load balancer » est devenu un raccourci pour « le truc devant mon application », même dans des configurations à serveur unique où rien n'est réellement réparti. Comprendre les deux missions d'un load balancer, la vérification de l'état des serveurs et la répartition du trafic, permet de voir clairement quand vous en avez besoin et quand vous payez pour une fonctionnalité que vous ne pouvez pas exploiter.
Load balancer : à quoi ça sert vraiment
Une fois le discours marketing écarté, un load balancer fait deux choses : il décide quel backend reçoit chaque requête, et il décide si un backend a le droit de recevoir des requêtes. Tout le reste (terminaison TLS, sticky sessions, routage par chemin) repose sur ces deux missions.
Les load balancers opèrent à l'une de ces deux couches :
- Couche 4 (transport) : ne travaille que sur les en-têtes IP et TCP/UDP. Il transfère les paquets en fonction de l'IP et du port, sans aucune visibilité sur le contenu HTTP. Le Network Load Balancer d'AWS et le Load Balancer d'Azure sont tous deux strictement L4.
- Couche 7 (application) : termine la connexion, analyse le HTTP (ou gRPC/WebSocket) et route selon l'hôte, le chemin, les en-têtes ou les cookies. L'Application Load Balancer d'AWS et le load balancer HTTP(S) de GCP fonctionnent ainsi.
| Couche 4 | Couche 7 | |
|---|---|---|
| Voit | IP + port | Requête HTTP complète |
| Peut router par chemin/hôte | Non | Oui |
| Termine le TLS | Passthrough uniquement | Oui |
| Préserve l'IP du client | Nativement (ou via le PROXY protocol) | Via l'en-tête X-Forwarded-For / Forwarded |
| Usage typique | TCP brut, débit élevé, protocoles non HTTP | Applications web, API, microservices |
La ligne sur l'IP du client compte plus qu'il n'y paraît. Un load balancer L4 qui termine la connexion TCP doit tout de même indiquer au backend qui était le véritable client : c'est précisément le rôle du PROXY protocol, maintenu par HAProxy. Un load balancer L7, lui, insère des en-têtes : X-Forwarded-For est la convention informelle que chacun implémente un peu différemment, tandis que la RFC 7239 définit un en-tête Forwarded standardisé que peu d'outils utilisent réellement. Si votre application journalise l'IP du load balancer au lieu de celle du visiteur, c'est presque toujours pour cette raison.
Health checks : comment un load balancer détecte un serveur hors service
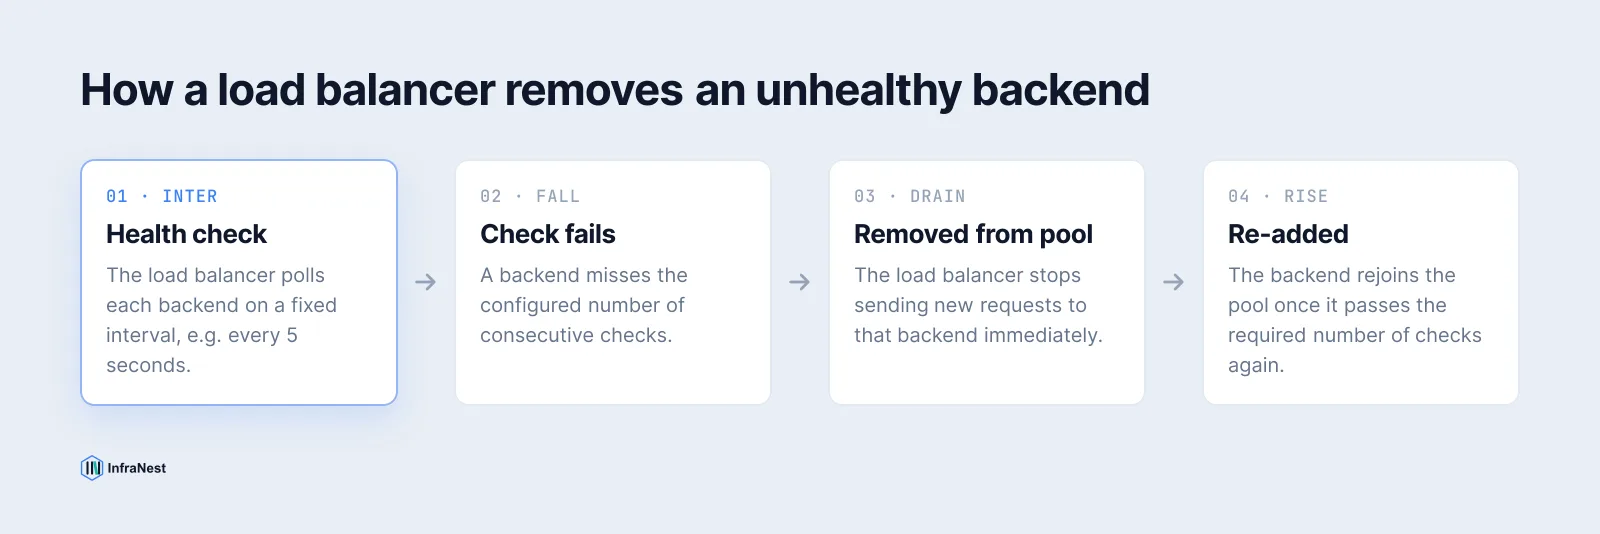
Un load balancer incapable de détecter un backend hors service n'est qu'un simple répartiteur de trafic : c'est le health check qui le rend résilient. Il interroge chaque backend à intervalle régulier, et dès qu'un backend échoue à suffisamment de vérifications consécutives, il est immédiatement retiré de la rotation, sans modification DNS, sans intervention manuelle et sans envoyer de trafic à un serveur incapable de le traiter.
Voici un exemple HAProxy fonctionnel : option httpchk effectue un health check HTTP, et fall/rise définissent le nombre de vérifications consécutives qui font basculer l'état d'un backend :
backend web_servers
 balance roundrobin
 option httpchk GET /healthz
 http-check expect status 200
 server web1 10.0.0.11:80 check inter 5s fall 3 rise 2
 server web2 10.0.0.12:80 check inter 5s fall 3 rise 2
inter 5s interroge toutes les 5 secondes, fall 3 retire un serveur sain après 3 échecs, rise 2 le réintègre après 2 vérifications réussies. Les load balancers managés d'AWS fonctionnent de la même façon en coulisses, simplement configurés via la console ou l'API plutôt que par un fichier de configuration.
TipUn endpoint de health check doit vérifier que l'application peut réellement servir du trafic (connexion à la base de données, accessibilité du cache), et pas seulement que le processus tourne. Un
/healthzqui renvoie toujours200 OKn'a strictement aucun intérêt.
C'est aussi là que load balancing et uptime monitoring divergent : un health check éloigne le mauvais trafic d'un backend au sein d'un pool, tandis qu'une surveillance externe vous signale que l'ensemble du service est indisponible. En général, il vous faut les deux. Pour la seconde, consultez notre guide sur la surveillance de site web.
Sticky sessions : pourquoi l'affinité de session est un contournement
Les load balancers répartissent les requêtes, mais de nombreuses applications stockent l'état de session (un panier, une connexion) dans la mémoire locale du serveur. Envoyez la deuxième requête vers un autre backend que la première, et cet état disparaît.
Les sticky sessions (affinité de session) résolvent ce problème en liant un client à un backend pendant toute la durée d'une session, généralement via un cookie que le load balancer définit et lit à chaque requête, ou en hachant l'IP du client vers un backend constant. Mieux vaut être lucide sur ce que c'est : un contournement pour une application stateful, pas une fonctionnalité de load balancing. Cela annule d'ailleurs discrètement l'intérêt du load balancing pour ce client, puisque tout son trafic part désormais vers un seul serveur, quelle que soit la charge.
La meilleure solution à long terme consiste à rendre l'application stateless, en stockant les sessions dans un stockage partagé (Redis, une base de données) que n'importe quel backend peut lire. Le load balancer est alors libre de router uniquement selon la charge, et non selon l'historique. Si vous êtes contraint d'utiliser des sticky sessions pour l'instant, c'est une solution provisoire légitime ; ne la considérez simplement pas comme l'état final.
Les algorithmes de répartition de charge en bref
La plupart des load balancers utilisent le round robin par défaut, ce qui convient très bien jusqu'à ce que le trafic ou les caractéristiques des backends deviennent inégaux. Les options courantes :
- Round robin : les requêtes sont envoyées à chaque backend à tour de rôle, sans tenir compte de la charge. C'est le comportement par défaut de Nginx et HAProxy.
- Weighted round robin : même principe, mais les serveurs plus puissants reçoivent une part proportionnellement plus importante.
- Least connections : les nouvelles requêtes vont au backend qui a le moins de connexions actives.
- IP hash / hachage cohérent : l'IP d'un client est hachée vers un backend précis, ce qui offre une affinité de session sans stockage de sessions centralisé.
Pour la plupart des charges de travail HTTP, least connections (ou le « least outstanding requests » d'AWS ALB) gère mieux les durées de requête inégales que le round robin, car ce dernier ne sait pas, et ne se soucie pas, qu'un backend est encore occupé à traiter une requête lente.
Quand vous n'avez pas besoin d'un load balancer
Le cas du serveur unique est le plus évident : un load balancer placé devant un seul backend ajoute de la latence, un coût et un nouvel élément susceptible de tomber en panne, sans rien répartir. Ce qu'il vous faut alors, c'est un reverse proxy (Nginx, Caddy) pour la terminaison TLS et éventuellement un rate limiting basique : la partie répartition de charge d'un load balancer n'a tout simplement rien à faire.```
Quelques autres situations où un load balancer dédié n'est pas la bonne couche :
- Le DNS round robin peut répartir le trafic sur plusieurs enregistrements A/AAAA sans aucune couche de load balancing. Il n'offre toutefois aucun health check actif et reste soumis à la mise en cache par les résolveurs et les clients au-delà du TTL : le basculement est donc lent et inégal, pas instantané. Consultez notre guide sur la propagation DNS pour comprendre l'origine de ce délai.
- Le clustering au niveau des processus (le module
clusterde Node, plusieurs instances de service systemd derrière un seul socket) répartit la charge entre les cœurs CPU d'un même hôte, sans aucun saut réseau. - Les services Kubernetes
ClusterIPrépartissent déjà la charge entre les pods en interne viakube-proxy. Vous n'avez besoin d'un objet load balancer externe que lorsque le trafic doit entrer dans le cluster depuis l'extérieur. - Les CDN et réseaux edge assurent déjà une répartition géographique basée sur l'anycast pour le contenu statique et mis en cache : empiler un load balancer régional devant ce type de trafic est redondant.
Le point commun de tous ces cas : si quelque chose répartit déjà le trafic, ou s'il n'existe qu'une seule destination possible, un load balancer n'est que du surcoût. Ajoutez-en un lorsque vous ajoutez un deuxième backend qui doit partager du trafic réel et non cacheable, pas avant.
Choisir un type de load balancer
Si vous devez choisir entre les offres des fournisseurs, adaptez la couche au protocole : L4 (AWS NLB, Azure Load Balancer) pour le TCP/UDP brut ou lorsque vous devez préserver l'IP du client sans réécriture d'en-têtes ; L7 (AWS ALB, GCP HTTP(S) LB) pour tout ce qui repose sur HTTP et nécessite un routage par chemin ou par hôte. Si vous comparez les fournisseurs plus largement, notre comparatif Hetzner vs DigitalOcean vs AWS détaille côte à côte la façon dont chacun gère le load balancing et les serveurs.
NoteLes délais d'inactivité comptent plus qu'on ne le pense : AWS ALB applique par défaut un idle timeout de 60 secondes et ferme les connexions dont le client reste silencieux au-delà de cette fenêtre. Les backends en long-polling ou SSE nécessitent souvent de l'augmenter explicitement.
Gérer la configuration du load balancer en même temps que les serveurs qui se trouvent derrière est plus simple lorsque les deux sont au même endroit : la gestion des serveurs cloud d'InfraNest vous permet de provisionner, surveiller et automatiser vos serveurs chez plusieurs fournisseurs depuis un seul tableau de bord, au lieu de jongler avec la console de chaque cloud.
Questions fréquentes
#Un load balancer ajoute-t-il de la latence ?
Oui, un load balancer ajoute un saut réseau et, pour les load balancers de couche 7, le coût de la terminaison et du rétablissement de la connexion. En pratique, il s'agit généralement de quelques millisecondes, peu de chose comparé au temps de traitement du backend, mais ce n'est pas nul.
#Quelle est la différence entre un load balancer et un reverse proxy ?
Un reverse proxy se place devant un ou plusieurs backends et peut gérer la terminaison TLS, la mise en cache et le routage ; un load balancer est un reverse proxy spécialisé dans la répartition du trafic entre plusieurs backends. Des outils comme Nginx et HAProxy peuvent assurer les deux rôles à la fois.
#Ai-je besoin de sticky sessions si mon application est stateless ?
Non. Les sticky sessions servent à contourner les applications qui stockent l'état de session localement sur un serveur. Si votre application lit les sessions depuis un stockage partagé comme Redis, n'importe quel backend peut traiter n'importe quelle requête et l'affinité n'est pas nécessaire.
#Peut-on répartir la charge sans produit de load balancing dédié ?
Oui. Le DNS round robin, la répartition intégrée des services ClusterIP de Kubernetes et le clustering au niveau des processus sur un seul hôte peuvent tous répartir la charge sans couche de load balancing autonome, même si chacun sacrifie le health check actif ou la répartition entre plusieurs hôtes.
Essayez avec un outil gratuit
Cet article vous a-t-il été utile ?