Die Aufgabe eines Load Balancers ist eng umrissen: Er verteilt eingehenden Traffic auf mehrere Backend-Server, prüft, welche davon gesund sind, und leitet den Traffic an denen vorbei, die es nicht sind. Wenn du nur einen Server betreibst, bringt ein Load Balancer einen zusätzlichen Netzwerk-Hop, einen weiteren Kostenposten und eine neue Fehlerquelle mit, ohne irgendetwas zu verteilen – dann brauchst du einen Reverse Proxy, keinen Load Balancer.
Dieser Unterschied geht oft verloren, weil „Load Balancer“ zum Kürzel für „das Ding vor meiner App“ geworden ist – selbst in Single-Server-Setups, in denen gar nichts verteilt wird. Wenn du die beiden Aufgaben eines Load Balancers verstehst – Health Checks und Traffic-Verteilung –, wird schnell klar, wann du einen brauchst und wann du für eine Funktion bezahlst, die du nicht nutzen kannst.
Was macht ein Load Balancer eigentlich?
Lässt man das Marketing weg, erledigt ein Load Balancer zwei Dinge: Er entscheidet, welches Backend eine Anfrage bekommt, und er entscheidet, ob ein Backend überhaupt Anfragen erhalten darf. Alles andere – TLS-Terminierung, Sticky Sessions, pfadbasiertes Routing – baut auf diesen beiden Aufgaben auf.
Load Balancer arbeiten auf einer von zwei Schichten:
- Layer 4 (Transport) – arbeitet ausschließlich mit IP- und TCP/UDP-Headern. Er leitet Pakete anhand von IP und Port weiter, ohne Einblick in HTTP-Inhalte. Der Network Load Balancer von AWS und der Load Balancer von Azure sind beide reine L4-Lösungen.
- Layer 7 (Anwendung) – terminiert die Verbindung, parst HTTP (oder gRPC/WebSocket) und routet anhand von Host, Pfad, Headern oder Cookies. Der Application Load Balancer von AWS und der HTTP(S) Load Balancer von GCP funktionieren so.
| Layer 4 | Layer 7 | |
|---|---|---|
| Sieht | IP + Port | Vollständige HTTP-Anfrage |
| Kann nach Pfad/Host routen | Nein | Ja |
| Terminiert TLS | Nur Passthrough | Ja |
| Erhält Client-IP | Nativ (oder über PROXY protocol) | Über X-Forwarded-For- / Forwarded-Header |
| Typischer Einsatz | Rohes TCP, hoher Durchsatz, Nicht-HTTP-Protokolle | Web-Apps, APIs, Microservices |
Die Zeile zur Client-IP ist wichtiger, als sie aussieht. Ein L4-Load-Balancer, der TCP terminiert, muss dem Backend trotzdem mitteilen, wer der echte Client war – genau dafür gibt es das von HAProxy gepflegte PROXY protocol. Ein L7-Load-Balancer fügt stattdessen Header ein: X-Forwarded-For ist die informelle Konvention, die jeder ein wenig anders umsetzt, während RFC 7239 einen standardisierten Forwarded-Header definiert, den weniger Tools tatsächlich nutzen. Wenn deine App die IP des Load Balancers statt der des Besuchers loggt, liegt es fast immer daran.
Health Checks: Wie ein Load Balancer erkennt, dass ein Server ausgefallen ist
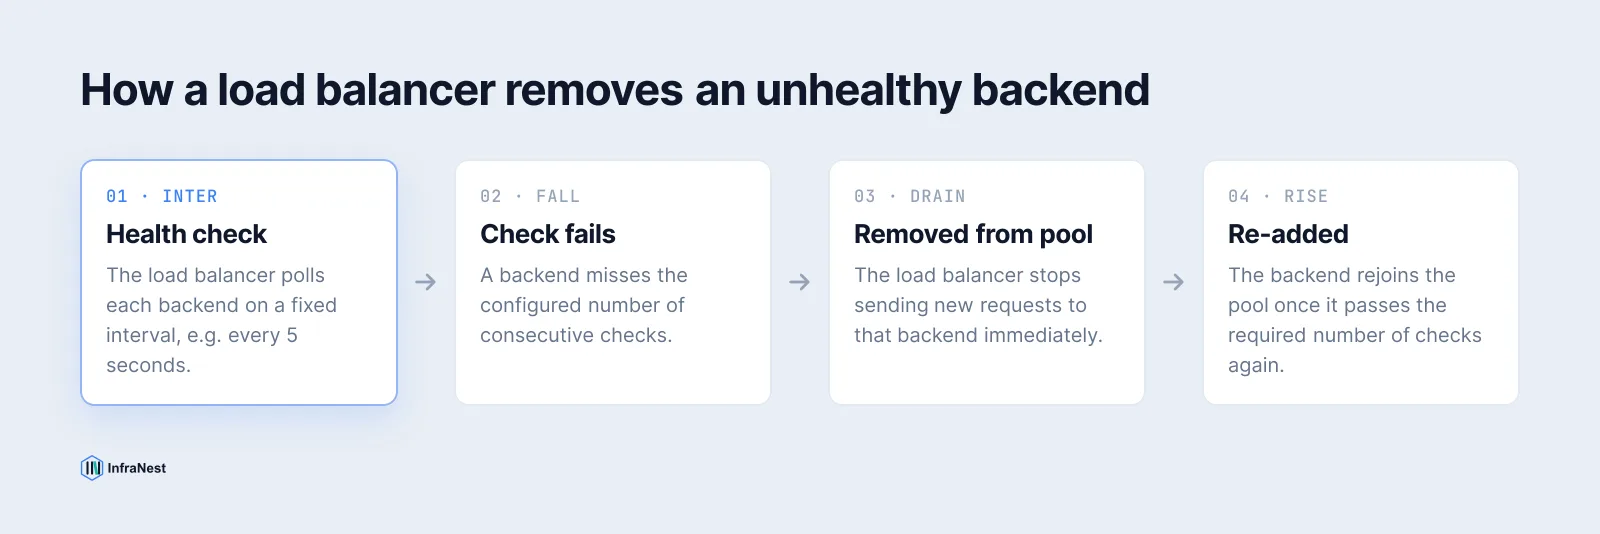
Ein Load Balancer, der ein ausgefallenes Backend nicht erkennt, ist nur ein Traffic-Splitter – erst der Health Check macht ihn ausfallsicher. Er fragt jedes Backend in festen Intervallen ab, und sobald ein Backend genügend aufeinanderfolgende Checks nicht besteht, wird es sofort aus der Rotation genommen – ohne DNS-Änderung, ohne manuellen Eingriff und ohne dass Traffic an einen Server geht, der ihn nicht bedienen kann.
Hier ein funktionierendes HAProxy-Beispiel – option httpchk führt einen HTTP-Health-Check durch, und fall/rise legen fest, nach wie vielen aufeinanderfolgenden Checks sich der Zustand eines Backends ändert:
backend web_servers
 balance roundrobin
 option httpchk GET /healthz
 http-check expect status 200
 server web1 10.0.0.11:80 check inter 5s fall 3 rise 2
 server web2 10.0.0.12:80 check inter 5s fall 3 rise 2
inter 5s fragt alle 5 Sekunden ab, fall 3 nimmt einen gesunden Server nach 3 Fehlschlägen heraus, rise 2 nimmt ihn nach 2 erfolgreichen Checks wieder auf. Die verwalteten Load Balancer von AWS funktionieren unter der Haube genauso, nur dass du sie über die Konsole oder API statt über eine Konfigurationsdatei einrichtest.
TipEin Health-Check-Endpunkt sollte prüfen, ob die App tatsächlich Traffic bedienen kann – Datenbankverbindung, Erreichbarkeit des Caches –, nicht nur, ob der Prozess läuft. Ein
/healthz, der immer200 OKzurückgibt, verfehlt den ganzen Zweck.
Hier gehen Load Balancing und Uptime Monitoring auch getrennte Wege: Ein Health Check hält fehlerhaften Traffic von einem einzelnen Backend im Pool fern, während externes Monitoring dir meldet, dass der gesamte Dienst ausgefallen ist. In der Regel willst du beides – zu Letzterem findest du mehr in unserem Leitfaden zum Website-Monitoring.
Session-Handling: Warum Sticky Sessions nur ein Workaround sind
Load Balancer verteilen Anfragen, aber viele Apps speichern Session-Zustand – einen Warenkorb, einen Login – im lokalen Arbeitsspeicher des Servers. Geht die zweite Anfrage an ein anderes Backend als die erste, ist dieser Zustand weg.
Sticky Sessions (Session-Affinität) lösen das, indem sie einen Client für die Dauer einer Session an ein Backend binden – meist über ein Cookie, das der Load Balancer setzt und bei jeder Anfrage ausliest, oder indem die IP des Clients per Hash einem festen Backend zugeordnet wird. Man sollte sich nüchtern klarmachen, was das ist: ein Workaround für eine zustandsbehaftete App, kein Load-Balancing-Feature. Außerdem hebelt es für diesen Client unbemerkt den Sinn des Load Balancings aus, da sein gesamter Traffic nun unabhängig von der Last an einen einzigen Server geht.
Die bessere langfristige Lösung ist, die App zustandslos zu machen – Sessions in einem gemeinsamen Speicher (Redis, eine Datenbank) abzulegen, den jedes Backend lesen kann –, damit der Load Balancer rein nach Last routen kann statt nach Verlauf. Wenn du vorerst auf Sticky Sessions angewiesen bist, ist das eine legitime Übergangslösung – betrachte sie nur nicht als Endzustand.
Load-Balancing-Algorithmen im Überblick
Die meisten Load Balancer nutzen standardmäßig Round Robin, und das passt, bis Traffic oder Backend-Ausstattung ungleichmäßig werden. Die gängigen Optionen:
- Round Robin – Anfragen gehen der Reihe nach an jedes Backend, ohne Rücksicht auf die Last. Standard bei Nginx und HAProxy.
- Weighted Round Robin – dasselbe, aber größere Server erhalten einen proportional größeren Anteil.
- Least Connections – neue Anfragen gehen an das Backend mit den wenigsten aktiven Verbindungen.
- IP-Hash / Consistent Hashing – die IP eines Clients wird per Hash einem bestimmten Backend zugeordnet, was Session-Affinität ohne zentralen Session-Speicher ermöglicht.
Bei den meisten HTTP-Workloads kommt Least Connections (oder „Least Outstanding Requests“ beim AWS ALB) besser mit ungleichen Anfragedauern zurecht als Round Robin, weil Round Robin nicht weiß und es ihm egal ist, dass ein Backend noch an einer langsamen Anfrage arbeitet.
Wann du keinen Load Balancer brauchst
Der Single-Server-Fall ist der eindeutigste: Ein Load Balancer vor genau einem Backend bringt Latenz, Kosten und eine neue mögliche Fehlerquelle mit, verteilt aber nichts. Was du dort eigentlich willst, ist ein Reverse Proxy (Nginx, Caddy) für TLS-Terminierung und eventuell einfaches Rate Limiting – die Lastverteilungshälfte eines Load Balancers hat schlicht nichts zu tun.```
Einige weitere Situationen, in denen ein dedizierter Load Balancer nicht die richtige Ebene ist:
- DNS Round Robin kann Traffic über mehrere A/AAAA-Records verteilen, ganz ohne Load-Balancer-Schicht. Allerdings gibt es kein aktives Health Checking, und Resolver sowie Clients cachen über die TTL hinaus – Failover ist daher langsam und ungleichmäßig, nicht sofort. Warum diese Verzögerung entsteht, erklärt unser Leitfaden zur DNS-Propagation.
- Clustering auf Prozessebene – das
cluster-Modul von Node, mehrere systemd-Service-Instanzen hinter einem Socket – verteilt die Last auf CPU-Kerne eines einzelnen Hosts, ganz ohne Netzwerk-Hop. - Kubernetes-
ClusterIP-Services verteilen die Last zwischen Pods bereits intern überkube-proxy. Ein externes Load-Balancer-Objekt brauchst du nur, wenn Traffic von außen in den Cluster gelangen muss. - CDNs und Edge-Netzwerke übernehmen für statische und cachebare Inhalte bereits die geografische, Anycast-basierte Verteilung – einen regionalen Load Balancer davorzuschalten ist für diese Art von Traffic überflüssig.
Das Muster hinter all dem: Wenn bereits etwas anderes den Traffic verteilt oder es nur ein mögliches Ziel gibt, ist ein Load Balancer reiner Overhead. Füge einen hinzu, wenn du ein zweites Backend ergänzt, das echten, nicht cachebaren Traffic mittragen soll – nicht früher.
Den richtigen Load-Balancer-Typ wählen
Wenn du zwischen den Angeboten eines Providers wählst, richte die Schicht nach dem Protokoll aus: L4 (AWS NLB, Azure Load Balancer) für rohes TCP/UDP oder wenn du die Client-IP ohne Header-Umschreibung erhalten musst; L7 (AWS ALB, GCP HTTP(S) LB) für alles HTTP-basierte, das Pfad- oder Host-Routing braucht. Wenn du Provider umfassender vergleichen willst, zeigt dir unser Vergleich Hetzner vs DigitalOcean vs AWS, wie jeder von ihnen Load Balancing und Server handhabt – direkt nebeneinander.
NoteIdle-Timeouts sind wichtiger, als viele denken: Der AWS ALB nutzt standardmäßig einen Idle-Timeout von 60 Sekunden und schließt Verbindungen, bei denen der Client länger still bleibt. Bei Long-Polling- oder SSE-Backends muss dieser Wert oft explizit erhöht werden.
Die Konfiguration des Load Balancers zusammen mit den Servern dahinter zu verwalten, ist einfacher, wenn beides an einem Ort liegt – mit dem Cloud-Server-Management von InfraNest kannst du Server über verschiedene Provider hinweg von einem Dashboard aus bereitstellen, überwachen und automatisieren, statt mit der Konsole jeder Cloud einzeln zu jonglieren.
Häufig gestellte Fragen
#Erhöht ein Load Balancer die Latenz?
Ja, ein Load Balancer fügt einen Netzwerk-Hop hinzu und bei Layer-7-Load-Balancern zusätzlich den Aufwand, die Verbindung zu terminieren und neu aufzubauen. In der Praxis sind das meist nur wenige Millisekunden – wenig im Vergleich zur Verarbeitungszeit im Backend, aber eben nicht null.
#Was ist der Unterschied zwischen einem Load Balancer und einem Reverse Proxy?
Ein Reverse Proxy sitzt vor einem oder mehreren Backends und kann TLS-Terminierung, Caching und Routing übernehmen; ein Load Balancer ist ein Reverse Proxy, der darauf spezialisiert ist, Traffic auf mehrere Backends zu verteilen. Tools wie Nginx und HAProxy können beide Aufgaben gleichzeitig erfüllen.
#Brauche ich Sticky Sessions, wenn meine App zustandslos ist?
Nein. Sticky Sessions gibt es, um Apps zu umgehen, die Session-Zustand lokal auf einem Server speichern. Wenn deine App Sessions aus einem gemeinsamen Speicher wie Redis liest, kann jedes Backend jede Anfrage bedienen, und Affinität ist nicht nötig.
#Kann ich Last ohne ein dediziertes Load-Balancer-Produkt verteilen?
Ja. DNS Round Robin, das integrierte Load Balancing von Kubernetes-ClusterIP-Services und Clustering auf Prozessebene auf einem einzelnen Host können Last ohne eigenständige Load-Balancer-Schicht verteilen – allerdings verzichtet jede dieser Varianten entweder auf aktives Health Checking oder auf die Verteilung über mehrere Hosts.
Mit einem kostenlosen Tool ausprobieren
War dieser Artikel hilfreich?