Infrastructure drift is het verschil tussen de toestand die je configuratie of infrastructure-as-code (IaC) voorschrijft en de toestand die daadwerkelijk in productie draait. Het ontstaat telkens wanneer iemand of iets een live resource wijzigt (een server, een firewallregel, een DNS-record) zonder de source of truth bij te werken die die resource beschrijft. Laat je het op zijn beloop, dan wordt je ‘bewezen goede’ configuratie pure fictie.
Drift is geen bug in één specifieke tool. Het is een structureel risico van infrastructuur die wordt beheerd door meerdere mensen, providers en automatiseringspipelines, en het wordt erger naarmate je stack groeit.
Wat valt onder infrastructure drift?
Drift is elke afwijking tussen de gedeclareerde toestand (een Terraform-bestand, een CloudFormation-template, een export van een DNS-zone, een runbook) en de waargenomen toestand (wat de API van de provider op dit moment werkelijk teruggeeft). Het geldt voor bijna alles met een configuratie: compute-instances, security groups, loadbalancerregels, TLS-certificaten en DNS-records.
Een paar concrete voorbeelden:
- Iemand past in de AWS-console een security group-regel aan om een deploy te deblokkeren en vergeet die wijziging vervolgens in Terraform door te voeren.
- Een DNS-record wordt tijdens een incident rechtstreeks in het dashboard van een registrar aangepast, buiten de automatisering om die het normaal beheert.
- Een autoscaling group wisselt tijdens een patchronde naar een nieuwe AMI (Amazon Machine Image), waardoor de instanceconfiguratie verandert zonder dat je IaC daarvan weet.
- Twee teams beheren dezelfde DNS-zone met verschillende tools (het ene via Terraform, het andere handmatig) en hun wijzigingen overschrijven elkaar ongemerkt.
In al deze gevallen vertellen je gedocumenteerde infrastructuur en je echte infrastructuur een ander verhaal.
Hoe drift ongemerkt ontstaat
Drift ontstaat bijna nooit bewust. Het sluipt erin via een handvol bekende routes:
- Handmatige hotfixes. Iemand wijzigt tijdens een incident een live resource omdat dat sneller is dan via de pipeline, en het vervolgticket om de wijziging terug te zetten in de code wordt nooit opgepakt.
- Automatisering buiten de reguliere flow. Een los script, automatische patching door een provider of een actie van een supportengineer in de console wijzigt een resource waar je hoofd-IaC niets van weet.
- Gedeeld eigenaarschap (split-brain). Meerdere teams of tools beheren dezelfde resource. Dat komt veel voor bij DNS, waar een registrardashboard, een CDN en een Terraform-module allemaal claimen eigenaar te zijn van dezelfde zone.
- Wijzigingen aan de kant van de provider. Managed services werken af en toe onderliggende resources bij (gepatchte AMI's, geroteerde certificaten, aangepaste standaardwaarden) zonder dat jij iets doet.
- Verouderde
ignore_changesof onbeheerde attributen. Als je IaC-tool de opdracht heeft bepaalde velden te negeren, of ze helemaal niet bijhoudt, komen wijzigingen in die velden nooit naar boven als drift, ook al zijn ze echt.
Geen van deze routes vereist nalatigheid. Het is simpelweg wat er gebeurt wanneer infrastructuur meer dan één toegangsdeur heeft.
Hoe driftdetectie echt werkt
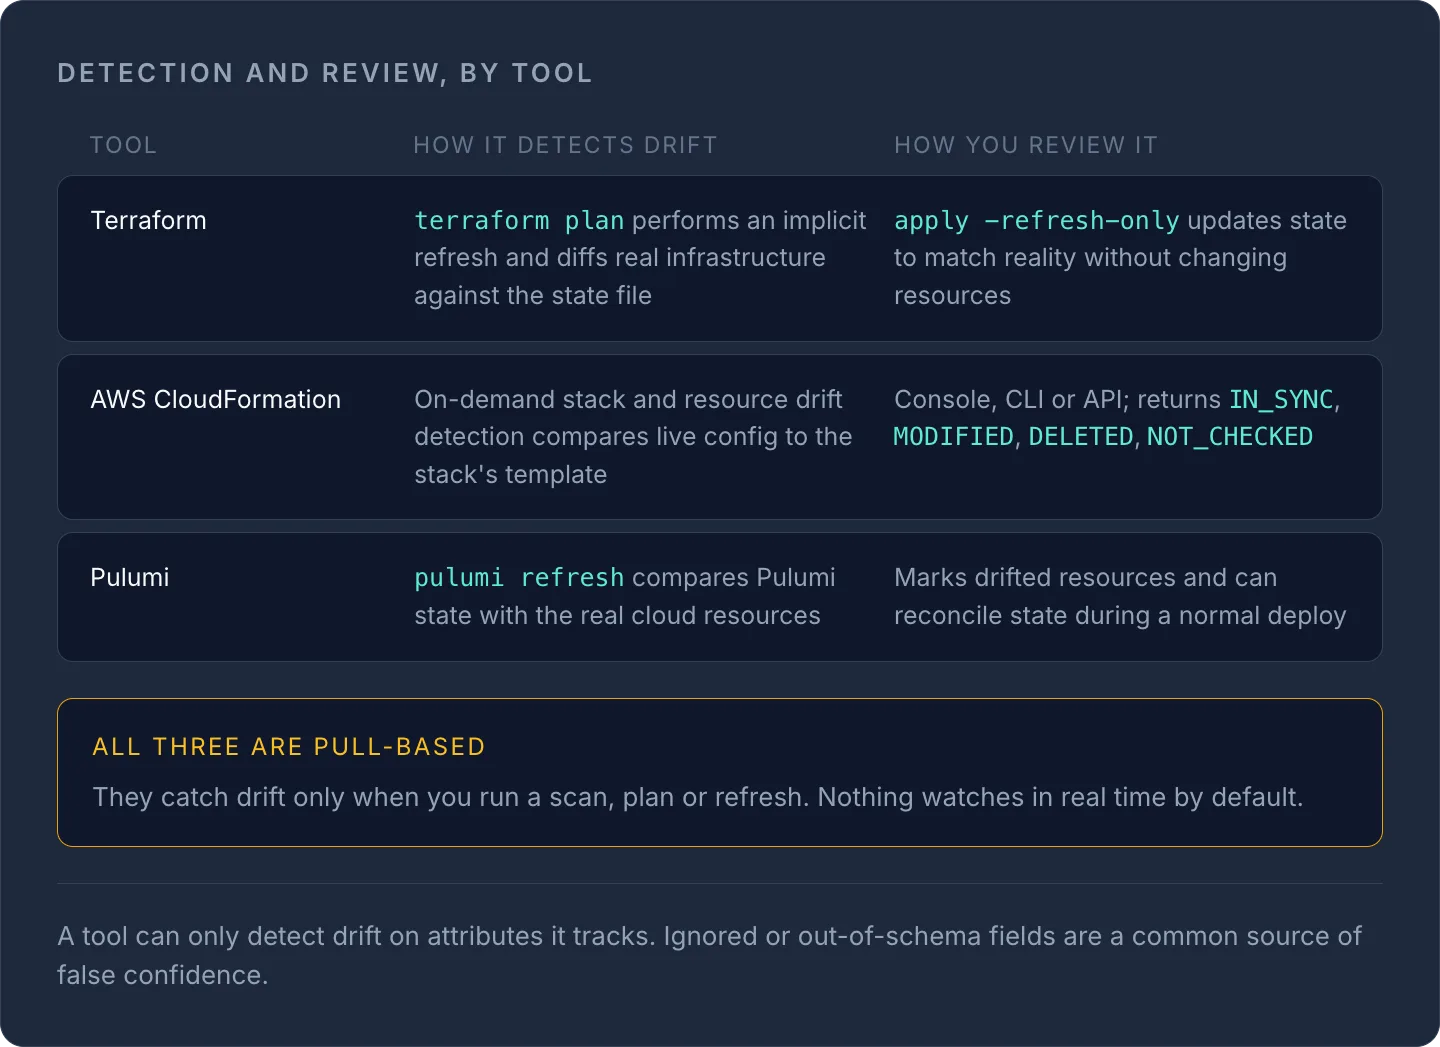
De meeste IaC-tools detecteren drift op dezelfde basale manier: ze vragen via de live API van de provider de huidige toestand van elke resource op en vergelijken die met de toestand die ze het laatst hebben vastgelegd. Zo werkt dat bij de belangrijkste tools.
| Tool | Hoe het drift detecteert | Hoe je het beoordeelt |
|---|---|---|
| Terraform | terraform plan voert impliciet een refresh uit, vergelijkt de echte infrastructuur met het state-bestand en toont het verschil |
terraform apply -refresh-only werkt de state bij naar de werkelijkheid zonder resources te wijzigen |
| AWS CloudFormation | On-demand driftdetectie op stack- en resourceniveau vergelijkt de live configuratie met de template van de stack | Console, CLI (detect-stack-drift) of API; geeft IN_SYNC, MODIFIED, DELETED of NOT_CHECKED terug |
| Pulumi | pulumi refresh (of pulumi up --refresh) vergelijkt de Pulumi-state met de echte cloudresources |
Markeert resources met drift en kan de state bijwerken als onderdeel van een normale deploy |
NoteAlle drie de benaderingen zijn pull-based: ze vangen drift alleen op wanneer je een scan, plan of refresh uitvoert. Geen van allen houdt standaard in realtime wijzigingen in de gaten, waardoor drift tussen twee runs uren of dagen onopgemerkt kan blijven.
Een typische workflow voor het beoordelen van drift in Terraform ziet er zo uit:
# Preview what has drifted, without touching any resources
terraform apply -refresh-only

# If the drift is expected/acceptable, accept the refreshed state
# If it's not, fix the real resource or update your .tf files, then:
terraform plan
terraform apply
Houd er ook rekening mee dat IaC-tools alleen drift kunnen detecteren op attributen die ze daadwerkelijk bijhouden. Velden die zijn uitgesloten via lifecycle { ignore_changes }, of die simpelweg buiten het schema van de tool vallen, verschijnen niet als drift, ook als ze wel gewijzigd zijn. Dat is een veelvoorkomende bron van vals vertrouwen.
Waarom DNS extra gevoelig is voor drift
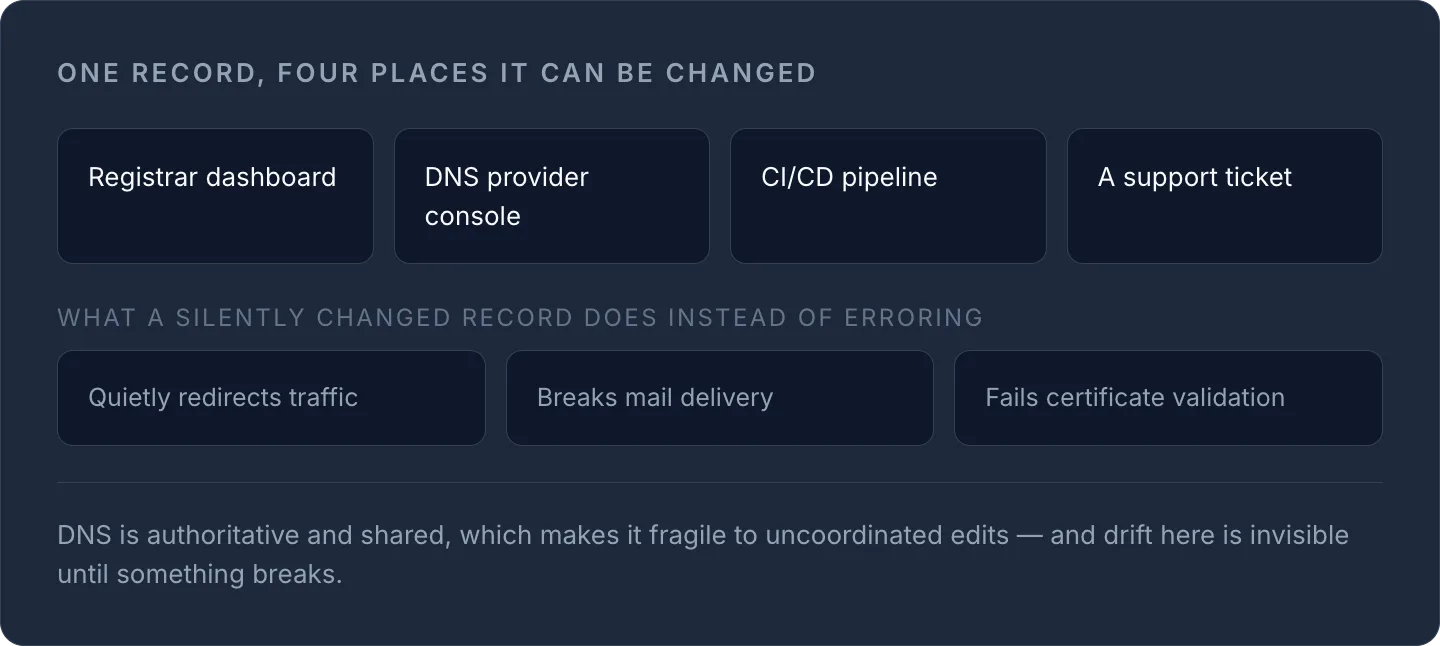
DNS is een van de meest driftgevoelige onderdelen van elke stack, om een eenvoudige reden: het is vanaf te veel plekken te bewerken. Een record kan worden gewijzigd via het dashboard van je registrar, de console van je DNS-provider, een CI/CD-pipeline of een supportticket, vaak door verschillende mensen die niet van elkaars wijzigingen weten. Anders dan bij een server waarop je via SSH kunt inloggen en rondkijken, leidt een ongemerkt gewijzigd DNS-record gewoon stilletjes verkeer om, verstoort het de mailbezorging of laat het een certificaatvalidatie mislukken, vaak zonder duidelijke foutmelding.
Dat is precies het gat dat ons artikel Hoe DNS-resolutie werkt vanuit de kant van de resolutie aanstipt. Drift is de change-managementkant van hetzelfde probleem: DNS is gezaghebbend en gedeeld, en daardoor kwetsbaar voor ongecoördineerde wijzigingen.
Driftrisico verkleinen in de praktijk
Drift helemaal uitbannen lukt niet (wijzigingen door providers en noodfixes blijven altijd voorkomen), maar je kunt de impact wel beperken:
- Centraliseer eigenaarschap. Kies per type resource één leidend systeem, vooral voor DNS, en laat alle wijzigingen daar doorheen lopen.
- Draai geplande refresh-/plan-jobs, niet alleen on-demand, zodat drift volgens een vast ritme naar boven komt in plaats van alleen wanneer iemand eraan denkt om te controleren.
- Stel alerts in op onverwachte wijzigingen in plaats van te vertrouwen op handmatige
plan-runs: continue, event-driven detectie vangt drift veel sneller op dan periodieke scans. - Houd een nauwkeurige inventaris bij van wat er bestaat en wie de eigenaar is; lees waarom een infrastructuurinventaris belangrijk is voor wat je moet bijhouden.
- Automatiseer routinewijzigingen zodat er minder reden is om überhaupt naar een console te grijpen. Onze gids over DNS-, SSL- en servertaken automatiseren over meerdere providers gaat hier direct op in.
DNS-drift opsporen voordat het tot een storing leidt
Omdat DNS-drift onzichtbaar is totdat er iets misgaat (een mailserver ontvangt niets meer, een subdomein verwijst ineens naar de verkeerde host), is continue detectie het nuttigst, niet geplande detectie. Het DNS-beheer van InfraNest bewaakt je zones bij alle registrars en providers vanuit één dashboard en signaleert onverwachte recordwijzigingen op het moment dat ze plaatsvinden, zodat je niet afhankelijk bent van iemand die eraan denkt een diff te draaien.
Wil je zien hoe continue drift-alerting er in de praktijk uitziet? Bekijk dan DNS-beheer en ontdek hoe het in de rest van je stack past.
Veelgestelde vragen
#Is infrastructure drift hetzelfde als configuration drift?
Het zijn nauw verwante termen die vaak door elkaar worden gebruikt. Configuration drift verwijst meestal naar servers of instellingen op OS-niveau die afwijken van een baseline, terwijl infrastructure drift de bredere term is voor elke resource (compute, netwerk, DNS) die afwijkt van de gedeclareerde toestand.
#Kan driftdetectie storingen voorkomen?
Driftdetectie alleen vertelt je dat er iets is veranderd; het houdt de wijziging zelf niet tegen. Het verkleint het risico op storingen door de tijd te verkorten tussen het moment waarop een ongewenste wijziging plaatsvindt en het moment waarop iemand die opmerkt, vooral in combinatie met alerting in plaats van handmatige, geplande controles.
#Elimineer je drift door Terraform of CloudFormation te gebruiken?
Nee. Deze tools detecteren drift wanneer je een plan, refresh of driftdetectiescan uitvoert, maar ze kunnen niet voorkomen dat er wijzigingen buiten de reguliere flow om plaatsvinden, en ze zien geen attributen die buiten hun bijgehouden schema vallen. Drift is net zo goed een procesprobleem als een toolingprobleem.
#Waarom is DNS-drift lastiger op te sporen dan drift op servers?
DNS-records zijn doorgaans te bewerken via meerdere dashboards, registrars en pipelines zonder één source of truth, en een foute wijziging levert vaak geen foutmelding op (alleen een stilletjes verkeerde resolutie), waardoor het onopgemerkt kan blijven totdat gebruikers een probleem melden.
Probeer het met een gratis tool
Was dit artikel nuttig?