La dérive d'infrastructure (infrastructure drift) est l'écart entre l'état que votre configuration ou votre infrastructure as code (IaC) déclare et l'état réellement en place en production. Elle survient dès qu'une personne ou un processus modifie une ressource active (un serveur, une règle de pare-feu, un enregistrement DNS) sans mettre à jour la source de vérité qui la décrit. Si on la laisse s'installer, la dérive transforme votre configuration « de référence » en fiction.
La dérive n'est pas un bug propre à un outil en particulier. C'est un risque structurel lié à la gestion d'une infrastructure par plusieurs personnes, fournisseurs et pipelines d'automatisation, et il s'aggrave à mesure que votre stack grandit.
Qu'est-ce que la dérive d'infrastructure ?
La dérive désigne toute divergence entre l'état déclaré (un fichier Terraform, un template CloudFormation, un export de zone DNS, un runbook) et l'état observé (ce que l'API du fournisseur renvoie réellement à l'instant T). Elle concerne presque tout ce qui possède une configuration : instances de calcul, groupes de sécurité, règles de load balancer, certificats TLS et enregistrements DNS.
Quelques exemples concrets :
- Quelqu'un modifie une règle de groupe de sécurité dans la console AWS pour débloquer un déploiement, puis oublie de la reporter dans Terraform.
- Un enregistrement DNS est mis à jour directement dans le tableau de bord du registrar pendant un incident, en contournant l'automatisation qui le gère habituellement.
- Un groupe d'autoscaling bascule sur une nouvelle AMI (Amazon Machine Image) lors d'un cycle de correctifs, modifiant la configuration des instances à l'insu de votre IaC.
- Deux équipes gèrent la même zone DNS avec des outils différents (l'une via Terraform, l'autre à la main) et leurs modifications s'écrasent mutuellement sans bruit.
Dans chacun de ces cas, votre infrastructure documentée et votre infrastructure réelle racontent des histoires différentes.
Comment la dérive s'installe
La dérive n'est presque jamais intentionnelle. Elle s'installe par quelques chemins bien connus :
- Correctifs manuels à chaud. Quelqu'un modifie une ressource active pendant un incident parce que c'est plus rapide que de passer par le pipeline, et le ticket de suivi prévu pour reporter la modification n'est jamais traité.
- Automatisation hors circuit. Un script séparé, le patch automatique d'un fournisseur ou une action d'un ingénieur support dans la console modifie une ressource dont votre IaC principale n'a pas connaissance.
- Propriété éclatée. Plusieurs équipes ou outils gèrent la même ressource ; c'est courant avec le DNS, où le tableau de bord du registrar, un CDN et un module Terraform peuvent tous revendiquer la même zone.
- Modifications côté fournisseur. Les services managés mettent parfois à jour les ressources sous-jacentes (AMI corrigées, certificats renouvelés, valeurs par défaut modifiées) sans aucune action de votre part.
ignore_changesobsolètes ou attributs non gérés. Si votre outil d'IaC a pour consigne d'ignorer certains champs, ou ne les suit pas du tout, leurs modifications n'apparaîtront jamais comme une dérive, alors qu'elles sont bien réelles.
Aucune de ces situations ne suppose de négligence. C'est simplement ce qui arrive quand une infrastructure a plus d'une porte d'entrée.
Comment fonctionne la détection de dérive
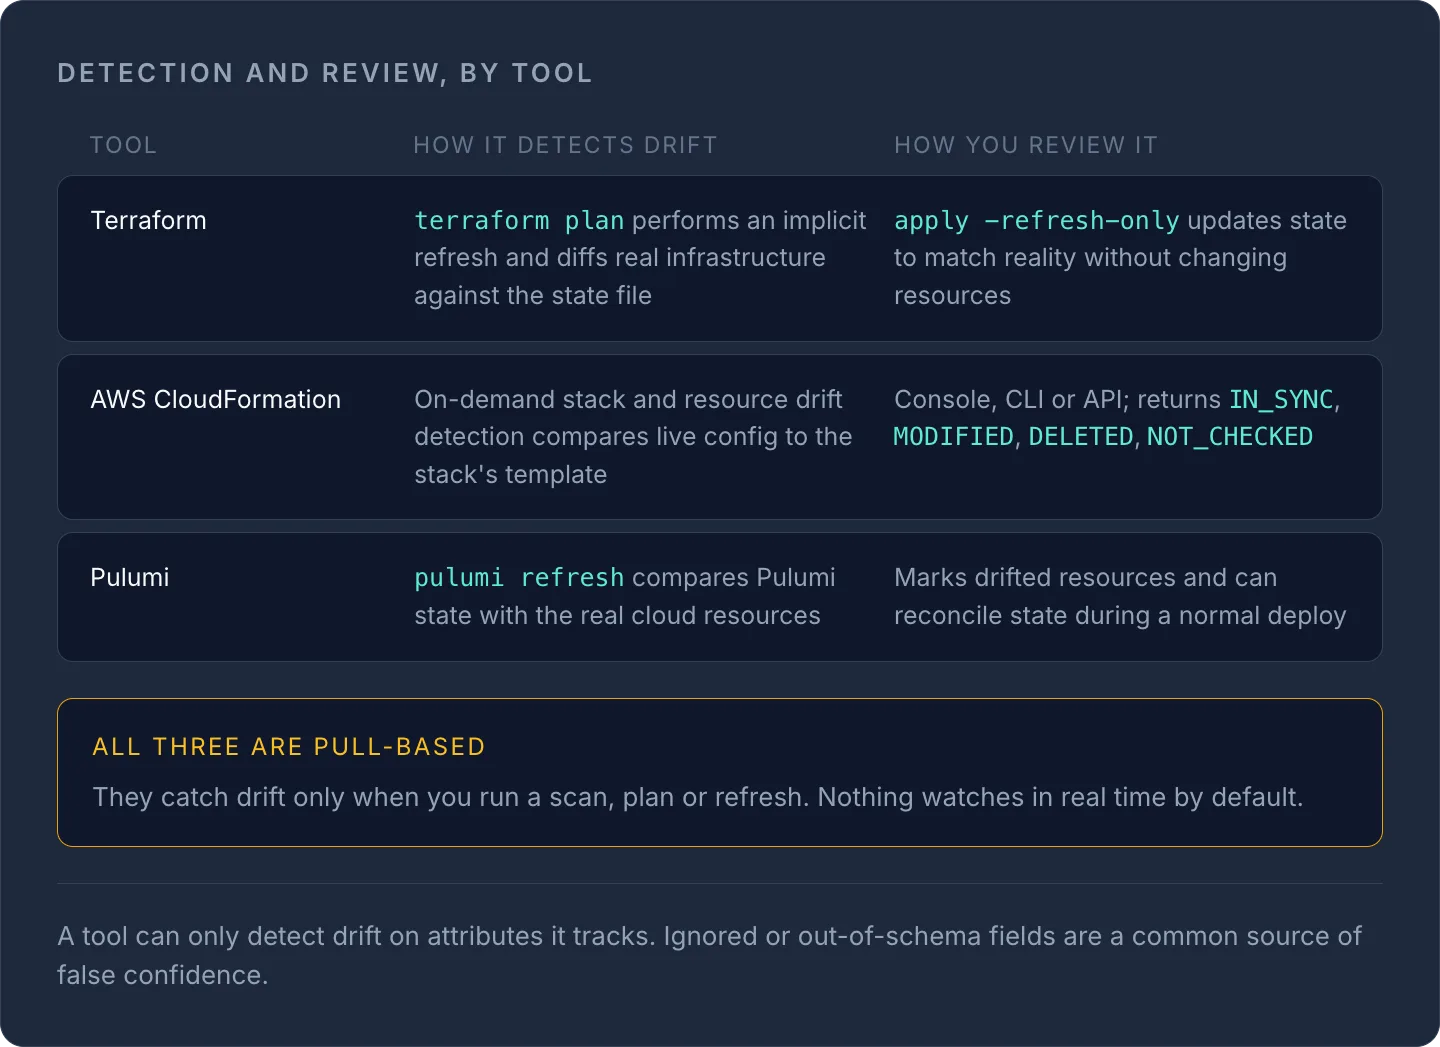
La plupart des outils d'IaC détectent la dérive selon le même principe : ils interrogent l'API du fournisseur pour connaître l'état actuel de chaque ressource, puis le comparent au dernier état enregistré. Voici comment cela se traduit dans les principaux outils.
| Outil | Comment il détecte la dérive | Comment l'examiner |
|---|---|---|
| Terraform | terraform plan effectue un refresh implicite, compare l'infrastructure réelle au fichier d'état et affiche le diff |
terraform apply -refresh-only met à jour l'état pour refléter la réalité sans modifier les ressources |
| AWS CloudFormation | La détection de dérive à la demande, au niveau de la stack ou de la ressource, compare la configuration active au template de la stack | Console, CLI (detect-stack-drift) ou API ; renvoie IN_SYNC, MODIFIED, DELETED ou NOT_CHECKED |
| Pulumi | pulumi refresh (ou pulumi up --refresh) compare l'état Pulumi aux ressources cloud réelles |
Signale les ressources ayant dérivé et peut réconcilier l'état lors d'un déploiement normal |
NoteCes trois approches fonctionnent en mode pull : elles ne détectent la dérive que lorsque vous lancez un scan, un plan ou un refresh. Aucune ne surveille les changements en temps réel par défaut, ce qui signifie qu'une dérive peut passer inaperçue pendant des heures, voire des jours, entre deux exécutions.
Un workflow classique d'examen de dérive avec Terraform ressemble à ceci :
# Preview what has drifted, without touching any resources
terraform apply -refresh-only

# If the drift is expected/acceptable, accept the refreshed state
# If it's not, fix the real resource or update your .tf files, then:
terraform plan
terraform apply
Notez aussi que les outils d'IaC ne peuvent détecter la dérive que sur les attributs qu'ils suivent réellement. Les champs exclus via lifecycle { ignore_changes }, ou tout simplement hors du schéma de l'outil, n'apparaîtront pas comme ayant dérivé même s'ils ont changé : une source fréquente de fausse assurance.
Pourquoi le DNS est particulièrement exposé à la dérive
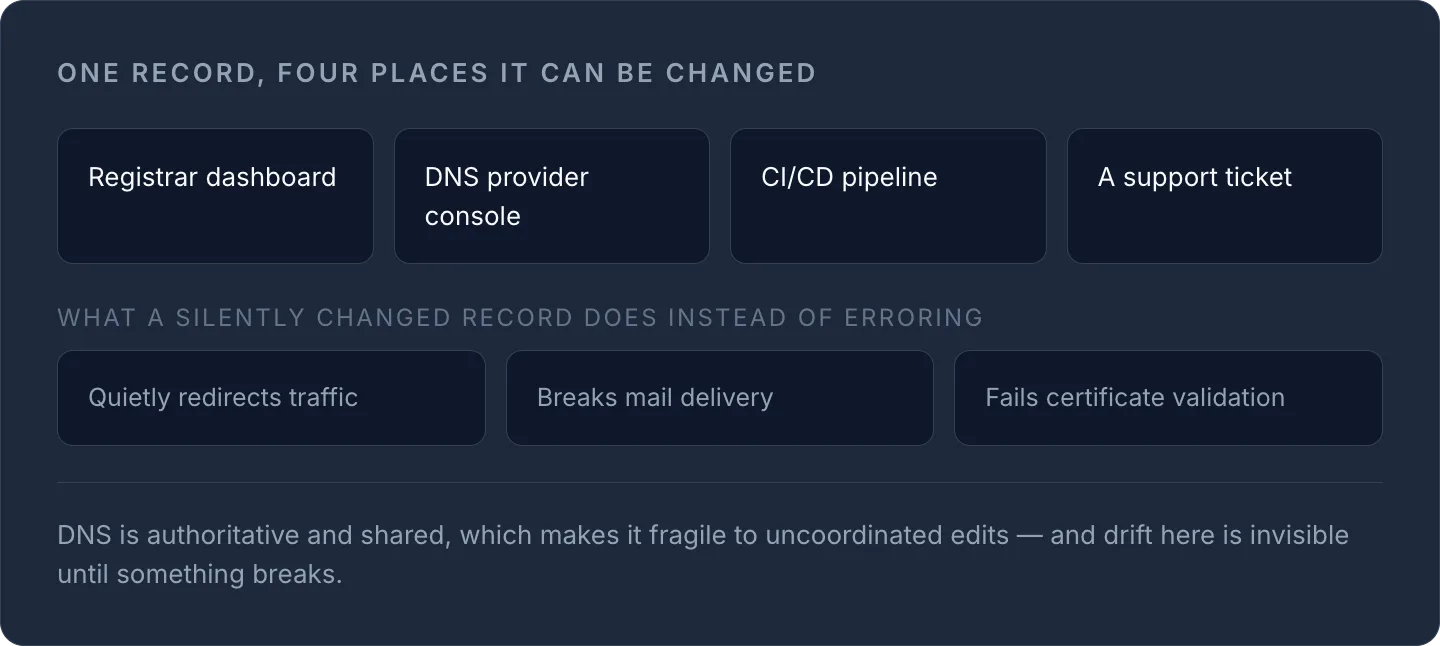
Le DNS est l'une des parties les plus sujettes à la dérive de toute stack, pour une raison simple : il est modifiable depuis trop d'endroits. Un enregistrement peut être changé via le tableau de bord de votre registrar, la console de votre fournisseur DNS, un pipeline CI/CD ou un ticket de support, souvent par des personnes différentes qui ignorent les modifications des autres. Contrairement à un serveur auquel vous pouvez vous connecter en SSH pour l'inspecter, un enregistrement DNS modifié en silence se contente de rediriger le trafic, de casser la distribution des e-mails ou de faire échouer une validation de certificat, souvent sans message d'erreur explicite.
C'est précisément le point qu'aborde notre article Comment fonctionne la résolution DNS du côté de la résolution ; la dérive en est le versant gestion des changements : le DNS fait autorité et il est partagé, ce qui le rend fragile face aux modifications non coordonnées.
Réduire le risque de dérive en pratique
Vous ne pouvez pas éliminer totalement la dérive (les modifications côté fournisseur et les correctifs d'urgence existeront toujours), mais vous pouvez en limiter l'impact :
- Centralisez la propriété. Choisissez un seul système de référence par type de ressource, en particulier pour le DNS, et faites passer toutes les modifications par lui.
- Planifiez des jobs de refresh/plan réguliers, pas seulement à la demande, afin que la dérive remonte à intervalles fixes et pas uniquement quand quelqu'un pense à vérifier.
- Déclenchez des alertes sur les changements inattendus plutôt que de compter sur des exécutions manuelles de
plan: une détection continue, pilotée par les événements, repère la dérive bien plus vite que des scans périodiques. - Tenez un inventaire précis de ce qui existe et de qui en est responsable ; consultez pourquoi l'inventaire d'infrastructure est important pour savoir quoi suivre.
- Automatisez les modifications courantes pour que personne n'ait de raison d'ouvrir une console en premier lieu ; notre guide sur l'automatisation des tâches DNS, SSL et serveur entre fournisseurs traite directement ce sujet.
Détecter la dérive DNS avant qu'elle ne provoque une panne
Comme la dérive DNS reste invisible jusqu'à ce que quelque chose casse (un serveur de messagerie qui ne reçoit plus rien, un sous-domaine qui pointe vers le mauvais hôte), la détection la plus utile est continue, et non planifiée. La gestion DNS d'InfraNest surveille vos zones chez tous vos registrars et fournisseurs depuis un seul tableau de bord et signale les modifications inattendues d'enregistrements au moment où elles se produisent, pour que vous n'ayez pas à compter sur quelqu'un qui pense à lancer un diff.
Si vous voulez voir à quoi ressemble concrètement l'alerte continue sur la dérive, découvrez la gestion DNS et voyez comment elle s'intègre au reste de votre stack.
Questions fréquentes
#La dérive d'infrastructure est-elle la même chose que la dérive de configuration ?
Ce sont des termes très proches, souvent employés indifféremment. La dérive de configuration désigne généralement des serveurs ou des paramètres au niveau de l'OS qui s'écartent d'une référence, tandis que la dérive d'infrastructure est le terme plus large qui couvre toute ressource (calcul, réseau, DNS) s'écartant de son état déclaré.
#La détection de dérive peut-elle éviter les pannes ?
La détection de dérive seule vous indique uniquement qu'un changement a eu lieu ; elle n'empêche pas ce changement de se produire. Elle réduit le risque de panne en raccourcissant le délai entre l'apparition d'un changement indésirable et le moment où quelqu'un le remarque, surtout lorsqu'elle est associée à des alertes plutôt qu'à des vérifications manuelles planifiées.
#Utiliser Terraform ou CloudFormation élimine-t-il la dérive ?
Non. Ces outils détectent la dérive lorsque vous lancez un plan, un refresh ou un scan de détection de dérive, mais ils ne peuvent pas empêcher les modifications hors circuit, ni voir les attributs situés hors de leur schéma suivi. La dérive est autant un problème de processus que d'outillage.
#Pourquoi la dérive DNS est-elle plus difficile à repérer que celle des serveurs ?
Les enregistrements DNS sont souvent modifiables depuis plusieurs tableaux de bord, registrars et pipelines sans source de vérité unique, et une mauvaise modification ne produit souvent aucune erreur, juste une résolution discrètement incorrecte. Elle peut donc passer inaperçue jusqu'à ce que des utilisateurs signalent un problème.
Essayez avec un outil gratuit
Cet article vous a-t-il été utile ?