Infrastructuurdrift is elk verschil tussen wat je configuratie zegt dat er zou moeten bestaan en wat er daadwerkelijk draait. De oplossing is niet elke handmatige wijziging voorkomen, maar drift snel opsporen, voordat het een storing of een beveiligingslek wordt, en dat betekent drift detection combineren met echte meldingen, niet alleen een dashboard dat je moet onthouden te bekijken.
Drift komt vaker voor dan de meeste teams toegeven. Iemand past op vrijdag rechtstreeks een A-record aan in de console van een registrar om een deploy vlot te trekken. Een externe kracht voegt tijdens een incident een firewallregel toe en vergeet die te documenteren. Een cloudprovider migreert automatisch een resource en verandert ongemerkt het IP-adres. Geen van deze wijzigingen verschijnt in je Git-geschiedenis en geen ervan leidt tot een pull request-review. Ze blijven gewoon staan tot er iets kapotgaat.
Wat is infrastructuurdrift precies?
Drift is het verschil tussen je gedeclareerde staat (een Terraform-bestand, een export van een DNS-zone, een CloudFormation-template) en de live staat van de daadwerkelijke resource. Infrastructure-as-code (IaC)-tools zoals Terraform en Pulumi detecteren het door de echte resource opnieuw uit te lezen en die te vergelijken met het laatst bekende state-bestand. terraform plan -refresh-only en pulumi refresh bestaan allebei specifiek hiervoor: ze rapporteren wat er in werkelijkheid is veranderd zonder voor te stellen het terug te overschrijven.
DNS-drift is een bijzondere, risicovolle variant van dit probleem. Je zonebestand, je IaC-repo of je ticketgeschiedenis zegt dat een record naar de ene plek moet wijzen, maar de gezaghebbende nameserver zegt iets anders. Omdat DNS vóór bijna alles staat (mail, de website, API-endpoints, SPF/DKIM-alignment), is een gedrift record zelden cosmetisch. Meestal is het het eerste symptoom van een groter probleem: een gecompromitteerd registraraccount, een vergeten migratiestap of een goedbedoelende engineer die een kapotte pipeline omzeilt in plaats van die te repareren.
Waarom out-of-band wijzigingen de meeste schade aanrichten
Elke wijziging die via je IaC-pipeline loopt, wordt gereviewd, gelogd en kan worden teruggedraaid. Out-of-band wijzigingen, die rechtstreeks in een providerconsole, een registrardashboard of via een supportticket worden gedaan, slaan dat allemaal over. Ze blijven onzichtbaar tot iemand het symptoom opmerkt (mail die terugkaatst, een certificaat dat niet klopt, een subdomein dat ergens onverwachts naartoe resolvet).
WarningEen gewijzigd MX- of CNAME-record kan er in je repo prima uitzien en in productie toch fout zijn, omdat de DNS-staat bij de registrar of DNS-host staat, niet in je code. Als je alleen je source of truth controleert, zie je nooit drift die daarna ontstaat.
Veelvoorkomende scenario's van out-of-band drift om in de gaten te houden:
- Een TTL (time to live) die tijdens een incident ongemerkt is verlengd en nooit is teruggezet, waardoor je volgende legitieme wijziging trager doorkomt.
- Een CNAME- of A-record dat door een externe integratie (een CDN, een e-mailplatform) is omgezet zonder dat je zonedocumentatie is bijgewerkt.
- Een SPF- of DKIM-TXT-record dat door een marketingtool is aangepast, waardoor de alignment ongemerkt breekt en je deliverability eronder lijdt.
- Een subdomein dat is achtergebleven nadat een dienst is uitgefaseerd en nu kwetsbaar is voor subdomain takeover.
- Een certificaat dat bij een andere provider opnieuw is uitgegeven, waardoor de keten verandert die je monitoring verwacht.
Wil je je kennis opfrissen over wat elk recordtype precies regelt, bekijk dan de complete gids over DNS-recordtypes.
Hoe drift detection werkt
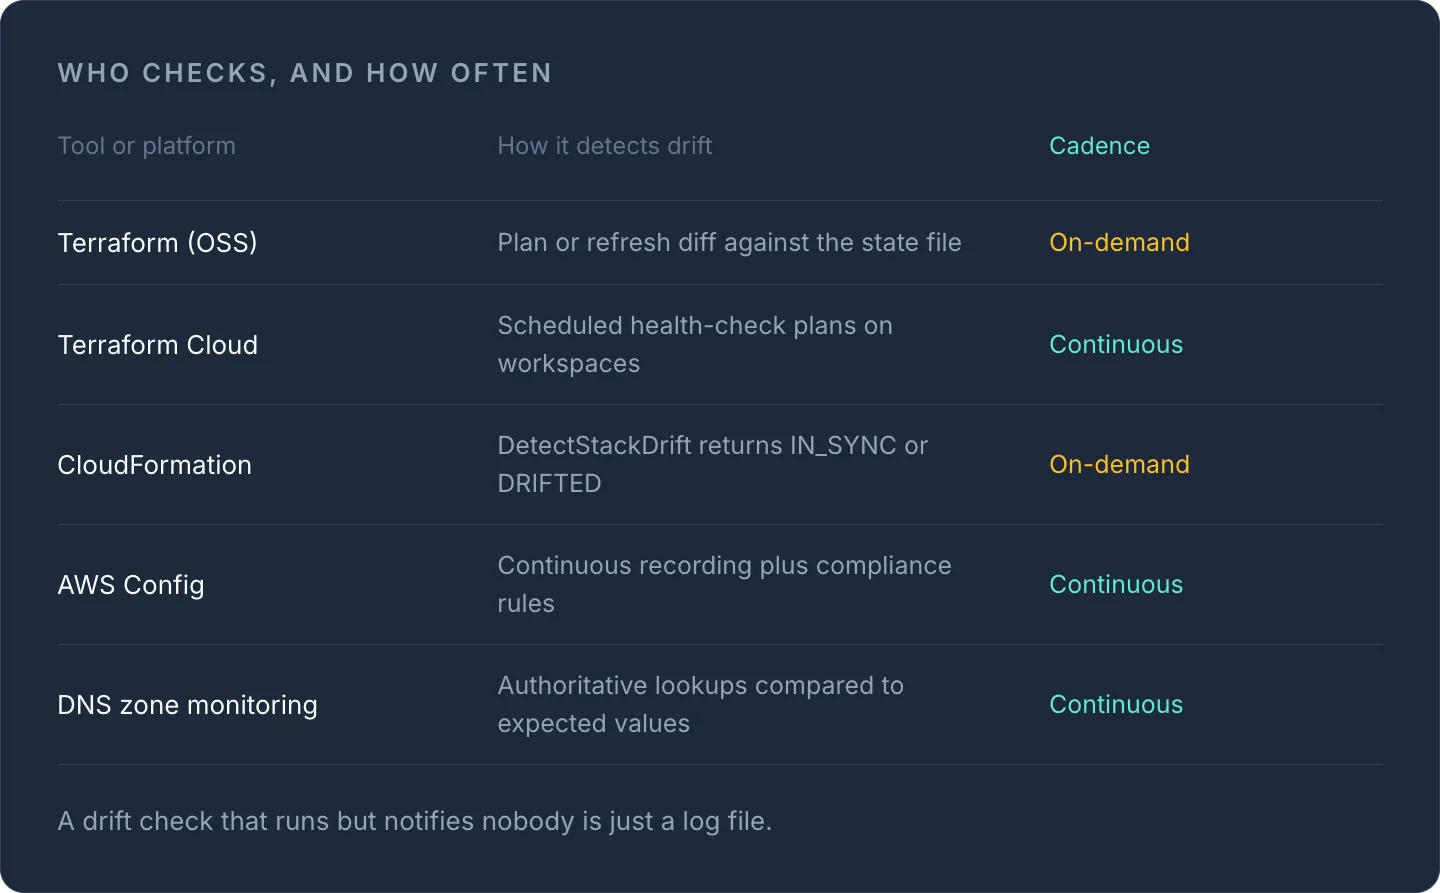
De meeste drift detection volgt dezelfde basiscyclus, of het nu om een cloudstack of een DNS-zone gaat: leg de huidige gewenste staat vast, lees periodiek de live staat opnieuw uit, vergelijk de twee en geef een melding bij elk verschil. De details verschillen per platform:
| Tool/platform | Hoe het drift detecteert | Continu of op aanvraag? |
|---|---|---|
| Terraform (OSS) | plan/refresh-vergelijking met het state-bestand |
Op aanvraag, handmatig of volgens een schema uitgevoerd |
| Terraform Cloud/Enterprise | Geplande health-check-plans op workspaces | Continu (betaald abonnement) |
| AWS CloudFormation | DetectStackDrift-API, geeft IN_SYNC / DRIFTED / NOT_CHECKED terug |
Op aanvraag (EventBridge + Lambda nodig voor planning) |
| AWS Config | Continue registratie + compliance-regels gekoppeld aan SNS/EventBridge | Continu |
| DNS-zonemonitoring | Periodieke gezaghebbende lookups vergeleken met verwachte waarden | Continu, afhankelijk van de provider |
Het patroon dat in productie echt problemen opspoort, is continue polling plus pushmeldingen, niet een rapport dat je eens per week opent. Een driftcontrole die draait maar niemand waarschuwt, is gewoon een logbestand.
DNS-driftmeldingen instellen in de praktijk
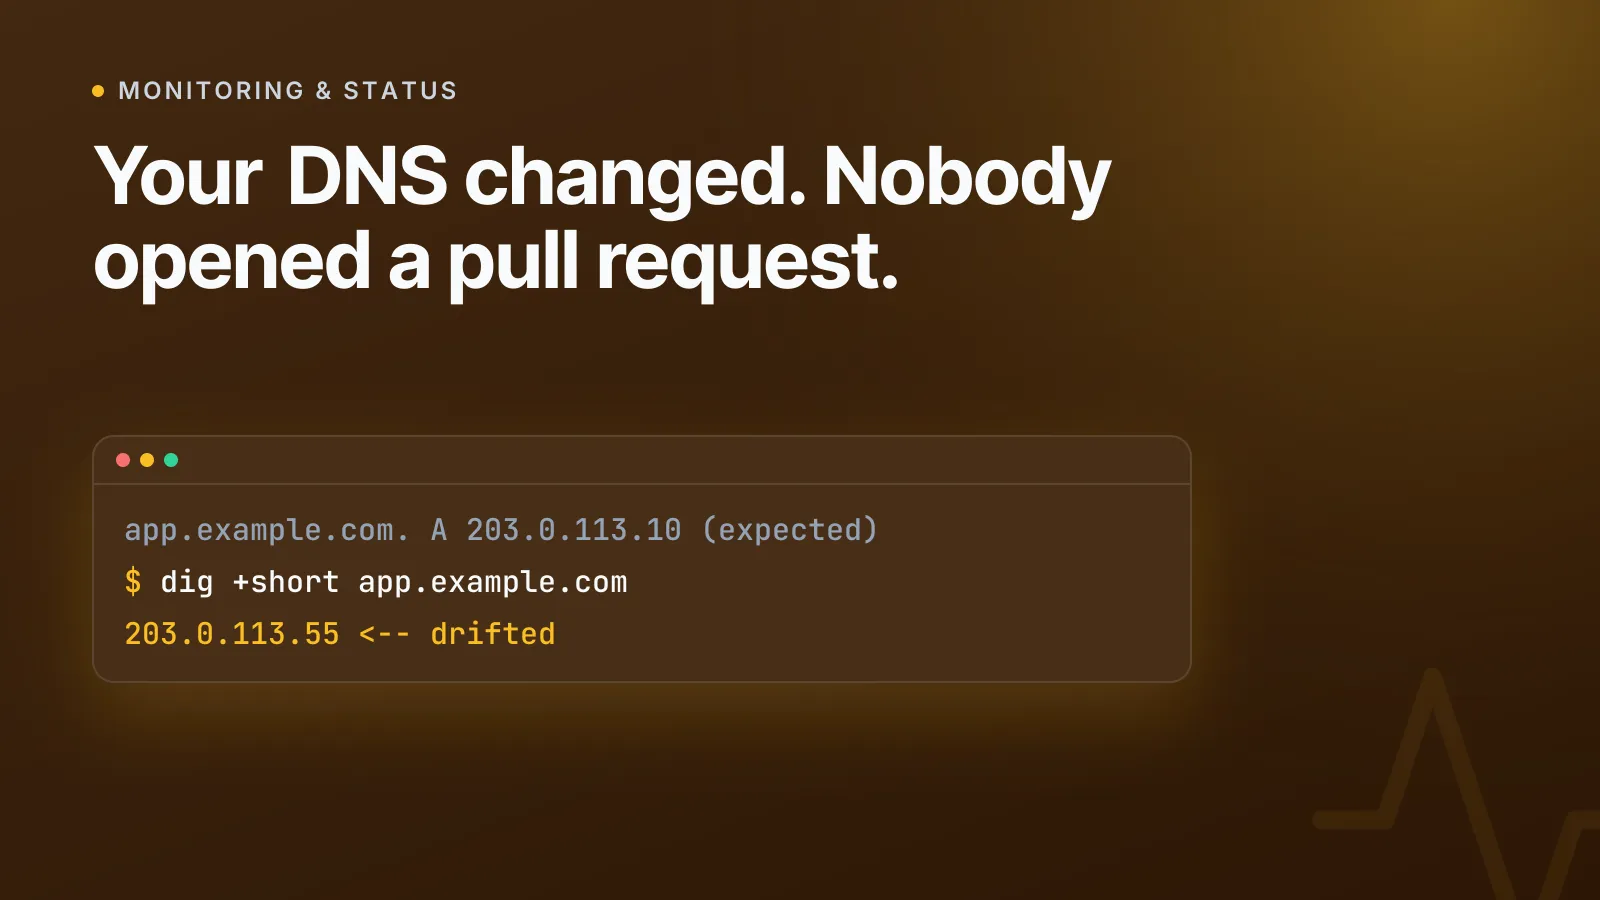
Je hebt geen volledige IaC-pipeline nodig om DNS-drift op te sporen. Leg minimaal vast waar elk record naartoe zou moeten resolven en vergelijk dat volgens een schema met waar het daadwerkelijk naartoe resolvet:
# Expected state (your source of truth)
app.example.com.    A      203.0.113.10
mail.example.com.   MX     10 mail.example.com.
example.com.        TXT    "v=spf1 include:_spf.example.com ~all"

# Observed state (queried live)
app.example.com.    A      203.0.113.55   <-- drifted
Met de gratis DNS lookup-tool kun je nu meteen elk afzonderlijk record controleren, handig om vermoedelijke drift te bevestigen voordat je escaleert. Maar voor blijvende bescherming wil je dat die vergelijking continu draait, met een melding die afgaat zodra een waarde verandert, in plaats van te vertrouwen op iemand die eraan denkt om te controleren.
Precies dit doet het DNS-beheer van InfraNest bij elke registrar en DNS-host die je gebruikt: het houdt de verwachte waarde van elk record bij en signaleert het moment waarop het live antwoord afwijkt, in plaats van te wachten op een supportticket. Combineer dat met uptime- en infrastructuurmonitoring, zodat een gedrift record dat echt iets kapotmaakt (een dood A-record, een mailserver die geen verbindingen meer accepteert) een tweede, onafhankelijke melding geeft op basis van de werkelijke impact, niet alleen de configuratiestaat.
TipGeef een melding bij de wijziging, niet alleen bij de storing. Een record dat ongemerkt naar een onbekend IP-adres wijst, is het onderzoeken waard, ook als de site nog laadt. Het kan via een malafide proxy of een overnamepoging resolven in plaats van via je echte server.
Wat te doen als er een driftmelding binnenkomt
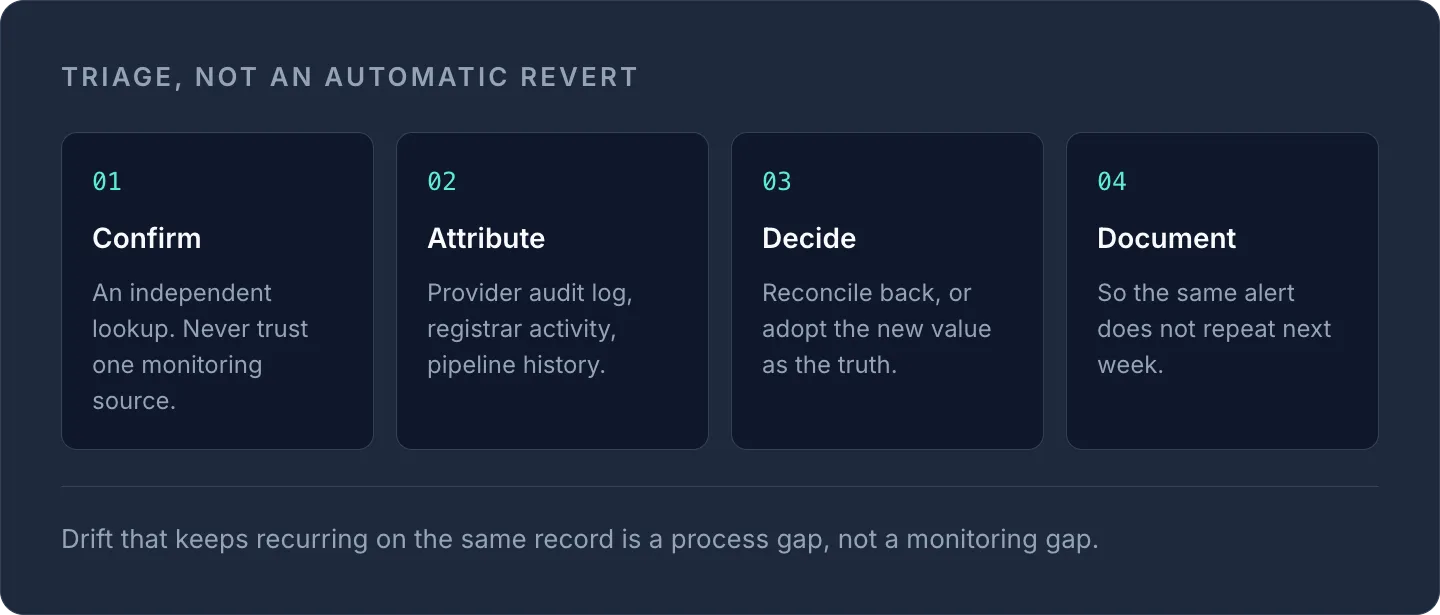
Behandel elke driftmelding als een triagevraag, niet als een automatische terugdraaiactie:
- Bevestig dat de wijziging echt is met een onafhankelijke lookup (vertrouw niet op één monitoringbron).
- Controleer wie of wat de wijziging heeft gedaan: het auditlog van de provider, het activiteitenlog van de registrar of de geschiedenis van je IaC-pipeline.
- Bepaal of je terugzet naar de gedeclareerde staat of de nieuwe waarde overneemt als nieuwe source of truth.
- Documenteer de beslissing, zodat dezelfde melding volgende week niet terugkomt.
Als drift steeds terugkomt bij hetzelfde record, is dat meestal een gat in het proces, niet in de monitoring. Iets (een script, een integratie, een persoon) heeft een structurele reden om je normale wijzigingsproces te omzeilen, en het loont om uit te zoeken wat dat is voordat je het symptoom blijft bestrijden. Voor teams die dit over meerdere clouds en registrars beheren, is het ook de moeite waard om te lezen hoe je DNS-, SSL- en servertaken bij elke provider automatiseert, zodat er überhaupt minder wijzigingen handmatig hoeven.
Aan de slag
Drift detection bewijst pas zijn waarde als het gekoppeld is aan een melding die daadwerkelijk iemand bereikt. Stel DNS-monitoring in voor je kritieke zones en voeg daar uptime monitoring aan toe, zodat je zowel de configuratiewijziging als de storing die eruit voortkomt opmerkt, welke van de twee iemand ook als eerste ziet.
Veelgestelde vragen
#Wat is het verschil tussen drift detection en monitoring?
Drift detection vergelijkt je gedeclareerde configuratie (een DNS-zone, een IaC-state-bestand) met de live resource om ongeautoriseerde wijzigingen op te sporen, terwijl monitoring controleert of een dienst daadwerkelijk online is en reageert. Je wilt allebei: drift detection vangt de oorzaak, monitoring vangt het gevolg.
#Kan DNS-drift ontstaan ook als ik mijn zonebestand nooit aanraak?
Ja. Externe integraties, CDN's, e-mailplatforms en zelfs de registrar zelf kunnen een record wijzigen buiten je normale wijzigingsproces om, zodat de zone kan driften zonder dat iemand in je team iets aanpast.
#Hoe vaak moet je DNS-records op drift controleren?
Continu controleren is best practice voor alles wat klanten raakt, omdat een gedrift MX- of A-record binnen enkele minuten invloed kan hebben op de mailbezorging of uptime. Als continu niet mogelijk is, controleer records met hoge waarde (root-A/AAAA, MX, SPF/DKIM-TXT) dan minstens dagelijks.
#Werkt drift detection voor cloudservers op dezelfde manier als voor DNS?
Het onderliggende idee is identiek: de gedeclareerde staat vergelijken met de live staat en een melding geven bij verschillen. Maar de werking verschilt. Drift detection in de cloud gebruikt doorgaans provider-API's zoals DetectStackDrift van AWS of refresh van Terraform, terwijl DNS-drift detection vertrouwt op live gezaghebbende lookups die worden vergeleken met de verwachte recordwaarden.
Probeer het met een gratis tool
Was dit artikel nuttig?