La dérive d'infrastructure (drift), c'est tout écart entre ce que votre configuration déclare et ce qui tourne réellement. La solution ne consiste pas à empêcher toute modification manuelle, mais à détecter la dérive rapidement, avant qu'elle ne se transforme en panne ou en faille de sécurité, ce qui implique d'associer la détection de dérive à de véritables alertes, et pas seulement à un tableau de bord qu'il faut penser à consulter.
La dérive est plus fréquente que la plupart des équipes ne l'admettent. Quelqu'un modifie un enregistrement A directement dans la console d'un registrar pour débloquer un déploiement un vendredi. Un prestataire ajoute une règle de pare-feu pendant un incident et oublie de la documenter. Un fournisseur cloud migre automatiquement une ressource et change discrètement son adresse IP. Rien de tout cela n'apparaît dans votre historique Git, et rien ne déclenche de revue de pull request : ces changements restent là jusqu'à ce que quelque chose casse.
Qu'est-ce que la dérive d'infrastructure, exactement ?
La dérive est la différence entre votre état déclaré (un fichier Terraform, un export de zone DNS, un template CloudFormation) et l'état réel de la ressource. Les outils d'infrastructure as code (IaC) comme Terraform et Pulumi la détectent en relisant la ressource réelle et en la comparant au dernier fichier d'état connu : terraform plan -refresh-only et pulumi refresh existent précisément pour cela. Ils signalent ce qui a changé dans la réalité sans proposer de l'écraser.
La dérive DNS est un cas particulier, et à haut risque, de ce problème. Votre fichier de zone, votre dépôt IaC ou votre historique de tickets indique qu'un enregistrement doit pointer vers une destination, mais le serveur de noms faisant autorité en indique une autre. Comme le DNS se trouve en amont de presque tout (e-mail, site web, endpoints d'API, alignement SPF/DKIM), un enregistrement qui a dérivé est rarement anodin. C'est généralement le premier symptôme d'un problème plus grave : un compte de registrar compromis, une étape de migration oubliée, ou un ingénieur bien intentionné qui contourne un pipeline défaillant au lieu de le réparer.
Pourquoi les modifications hors processus sont les plus dangereuses
Toute modification passant par votre pipeline IaC est relue, journalisée et réversible. Les modifications hors processus, effectuées directement dans la console d'un fournisseur, le tableau de bord d'un registrar ou via un ticket de support, échappent à tout cela. Elles restent invisibles jusqu'à ce que quelqu'un remarque le symptôme (e-mails rejetés, certificat qui ne correspond pas, sous-domaine qui résout vers une destination inattendue).
WarningUn enregistrement MX ou CNAME modifié peut sembler parfaitement correct dans votre dépôt tout en étant faux en production, car l'état DNS réside chez le registrar ou l'hébergeur DNS, et non dans votre code. Si vous ne vérifiez jamais que votre source de vérité, vous ne verrez jamais la dérive qui se produit en aval.
Scénarios courants de dérive hors processus à surveiller :
- Un TTL (time to live) discrètement allongé pendant un incident et jamais rétabli, ce qui ralentit votre prochaine modification légitime.
- Un enregistrement CNAME ou A redirigé par une intégration tierce (un CDN, une plateforme d'e-mailing) sans mise à jour correspondante de la documentation de votre zone.
- Un enregistrement TXT SPF ou DKIM modifié par un outil marketing, qui casse silencieusement l'alignement et nuit à la délivrabilité.
- Un sous-domaine oublié après la mise hors service d'un service, désormais vulnérable à une prise de contrôle de sous-domaine (subdomain takeover).
- Un certificat réémis chez un autre fournisseur, qui modifie la chaîne attendue par votre monitoring.
Pour un rappel sur ce que contrôle réellement chaque type d'enregistrement, consultez le guide complet des types d'enregistrements DNS.
Comment fonctionne la détection de dérive
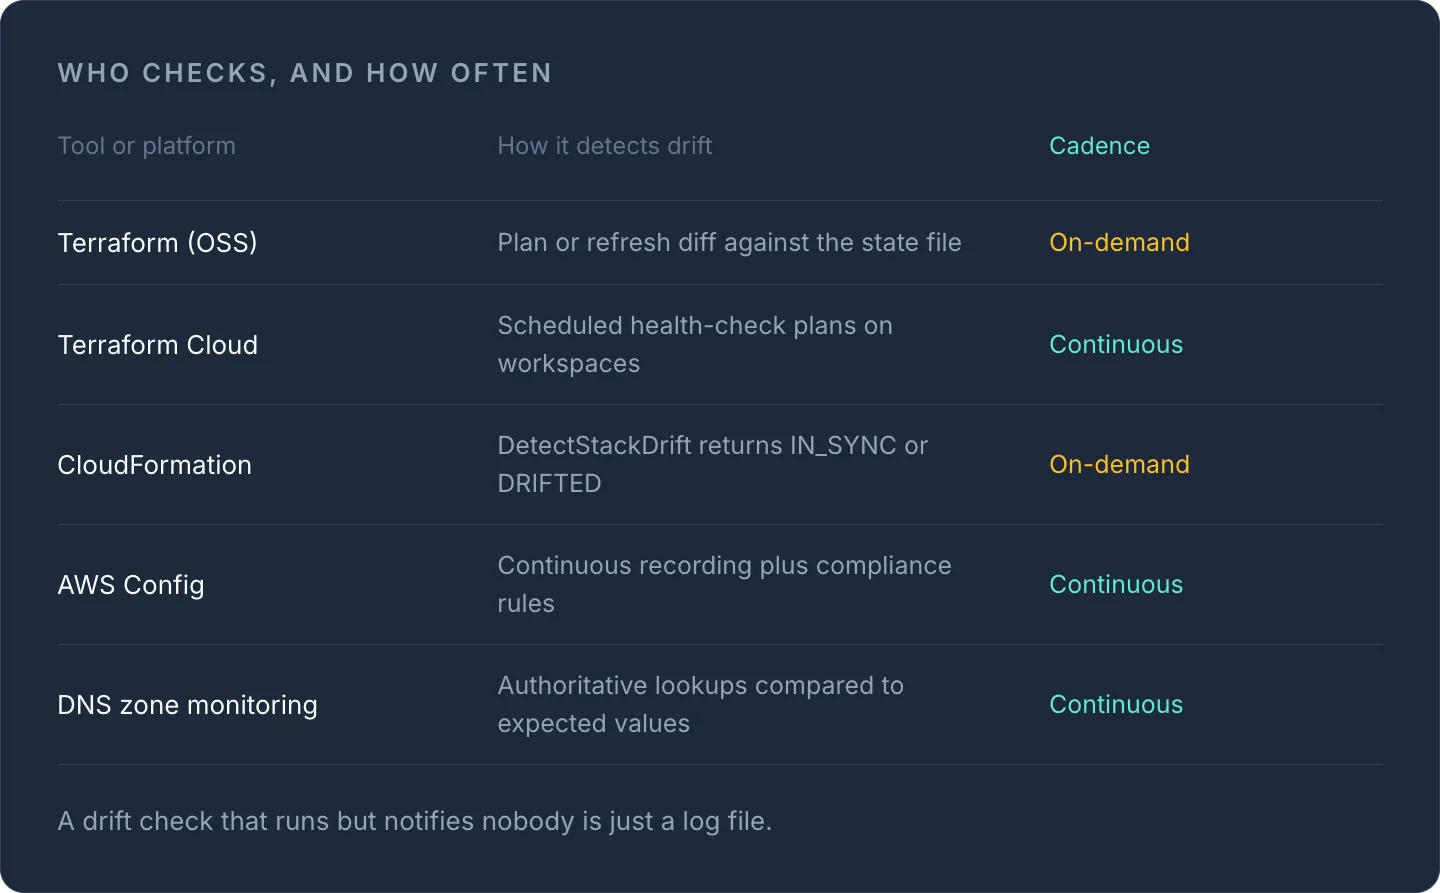
La plupart des mécanismes de détection de dérive suivent la même boucle de base, qu'ils s'appliquent à une stack cloud ou à une zone DNS : capturer l'état souhaité actuel, relire périodiquement l'état réel, comparer les deux et alerter en cas de différence. Les détails varient selon la plateforme :
| Outil/plateforme | Méthode de détection de la dérive | Continue ou à la demande ? |
|---|---|---|
| Terraform (OSS) | Diff plan/refresh par rapport au fichier d'état |
À la demande, exécution manuelle ou planifiée |
| Terraform Cloud/Enterprise | Plans de health check planifiés sur les workspaces | Continue (offre payante) |
| AWS CloudFormation | API DetectStackDrift, renvoie IN_SYNC / DRIFTED / NOT_CHECKED |
À la demande (nécessite EventBridge + Lambda pour la planification) |
| AWS Config | Enregistrement continu + règles de conformité reliées à SNS/EventBridge | Continue |
| Surveillance de zone DNS | Requêtes périodiques faisant autorité comparées aux valeurs attendues | Continue, selon le fournisseur |
Ce qui détecte réellement les problèmes en production, c'est l'interrogation continue associée à des alertes push, et non un rapport consulté une fois par semaine. Une vérification de dérive qui s'exécute sans prévenir personne n'est qu'un fichier de log.
Configurer des alertes de dérive DNS en pratique
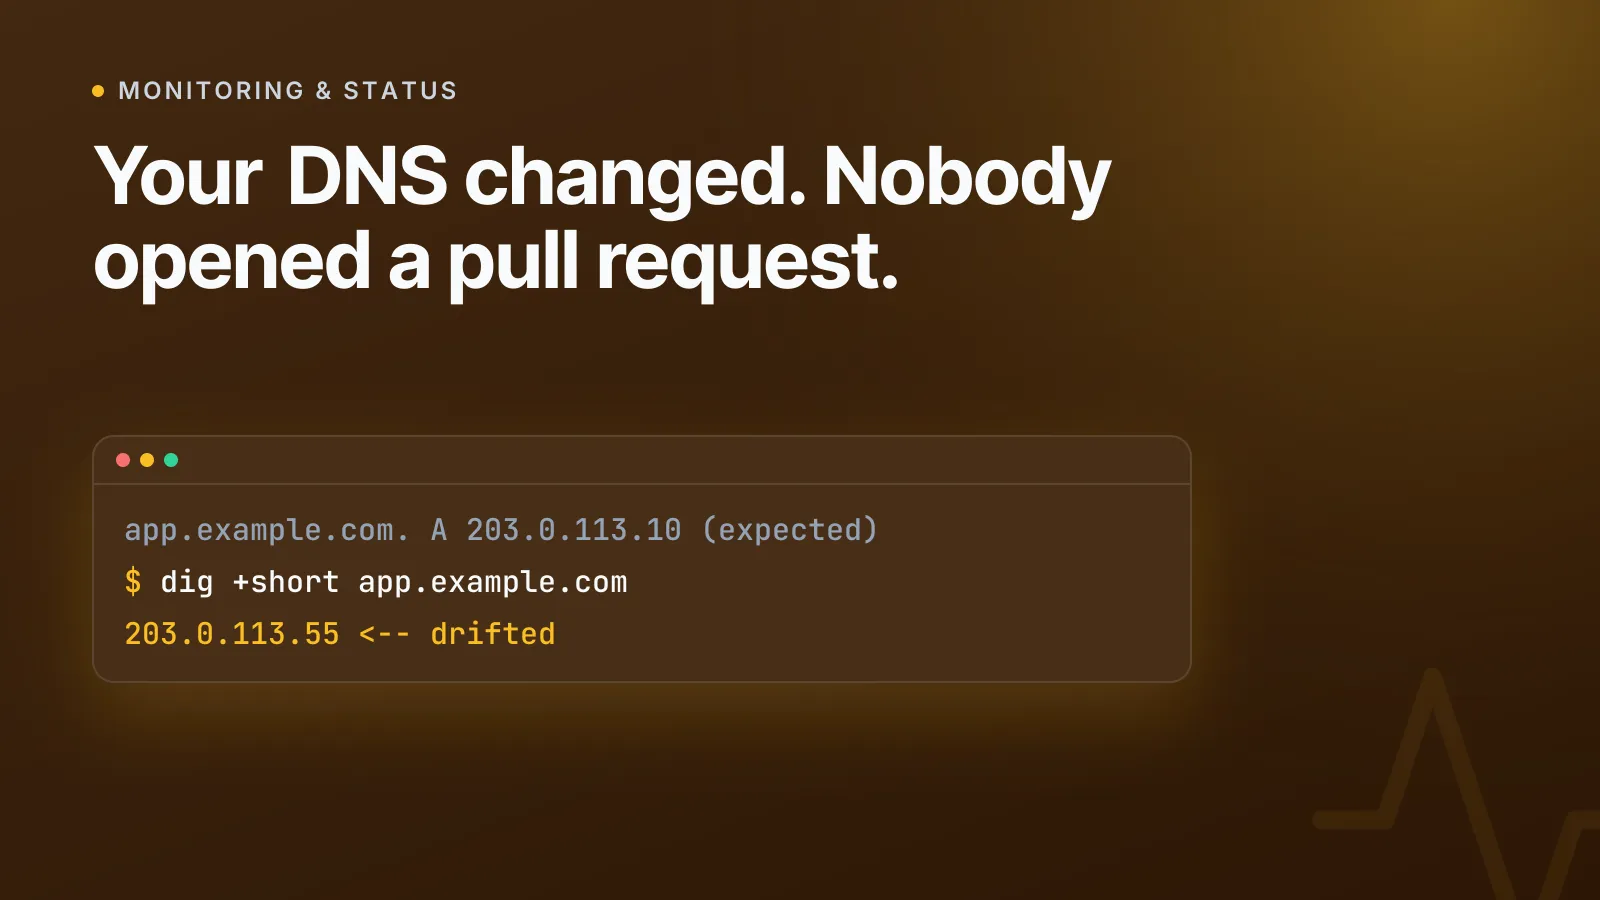
Pas besoin d'un pipeline IaC complet pour commencer à détecter la dérive DNS. Au minimum, définissez ce vers quoi chaque enregistrement devrait résoudre, puis comparez-le régulièrement avec ce vers quoi il résout réellement :
# Expected state (your source of truth)
app.example.com.    A      203.0.113.10
mail.example.com.   MX     10 mail.example.com.
example.com.        TXT    "v=spf1 include:_spf.example.com ~all"

# Observed state (queried live)
app.example.com.    A      203.0.113.55   <-- drifted
Vous pouvez dès maintenant vérifier ponctuellement n'importe quel enregistrement avec l'outil de recherche DNS gratuit, pratique pour confirmer une dérive suspectée avant de faire remonter l'incident. Mais pour une protection durable, cette comparaison doit tourner en continu, avec une alerte déclenchée dès qu'une valeur change, plutôt que de compter sur quelqu'un qui pense à vérifier.
C'est exactement ce que fait la gestion DNS d'InfraNest sur l'ensemble des registrars et hébergeurs DNS que vous utilisez : elle suit la valeur attendue de chaque enregistrement et signale le moment où la réponse réelle diverge, sans attendre un ticket de support. Associez-la à la surveillance de la disponibilité et de l'infrastructure pour qu'un enregistrement qui a dérivé et casse réellement quelque chose (un enregistrement A mort, un serveur de messagerie qui n'accepte plus de connexions) déclenche une seconde alerte, indépendante, fondée sur l'impact réel et pas seulement sur l'état de la configuration.
TipAlertez sur le changement, pas seulement sur la panne. Un enregistrement qui pointe silencieusement vers une IP inconnue mérite d'être examiné même si le site se charge encore : il pourrait résoudre via un proxy malveillant ou une tentative de prise de contrôle plutôt que vers votre vrai serveur.
Que faire quand une alerte de dérive se déclenche
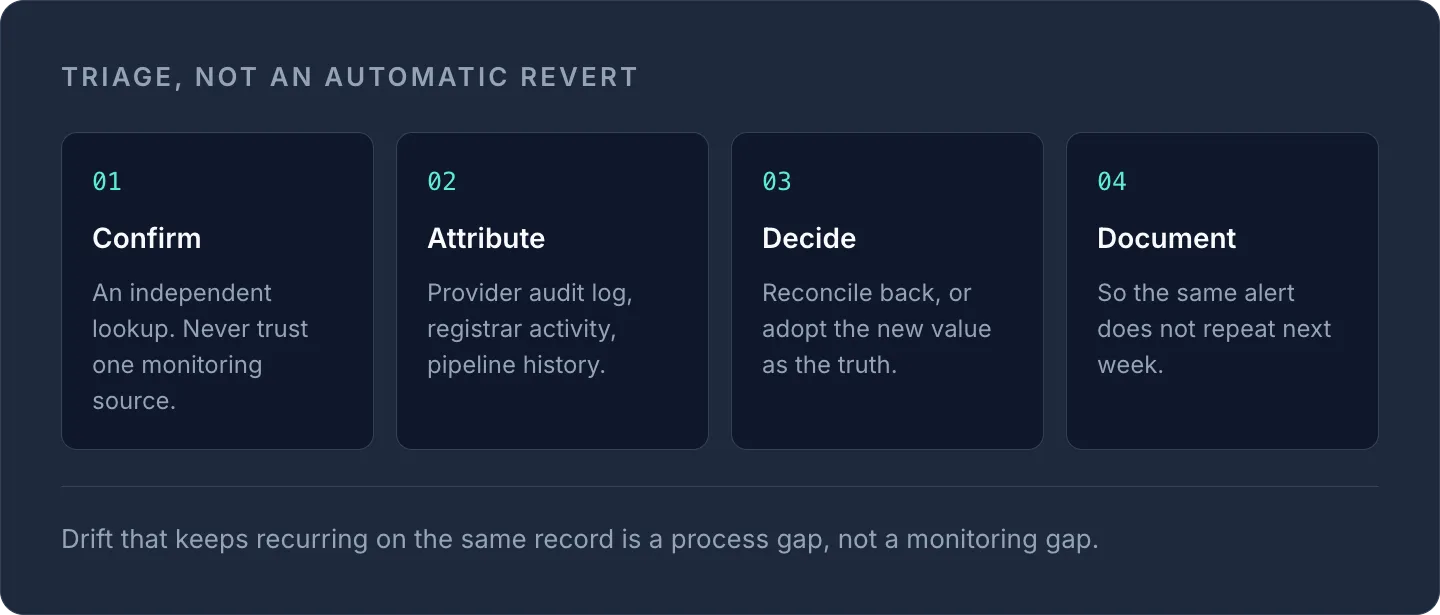
Traitez chaque alerte de dérive comme une question de tri, et non comme un retour arrière automatique :
- Confirmez que le changement est réel avec une requête indépendante (ne vous fiez pas à une seule source de monitoring).
- Identifiez qui ou quoi a effectué le changement : journal d'audit du fournisseur, journal d'activité du registrar ou historique du pipeline IaC.
- Décidez s'il faut revenir à l'état déclaré ou adopter la nouvelle valeur comme nouvelle source de vérité.
- Documentez la décision pour que la même alerte ne se reproduise pas la semaine suivante.
Si la dérive revient sans cesse sur le même enregistrement, c'est généralement un problème de processus, pas de monitoring : quelque chose (un script, une intégration, une personne) a une raison récurrente de contourner votre circuit de modification habituel, et il vaut la peine de l'identifier avant de continuer à éteindre l'incendie. Pour les équipes qui gèrent cela sur plusieurs clouds et registrars, il est aussi utile de lire comment automatiser les tâches DNS, SSL et serveur chez tous vos fournisseurs afin de réduire dès le départ le nombre de modifications manuelles.
Pour commencer
La détection de dérive n'est vraiment utile que si elle est associée à une alerte qui parvient effectivement à quelqu'un. Mettez en place la surveillance DNS sur vos zones critiques et ajoutez-y la surveillance de disponibilité, afin de détecter à la fois le changement de configuration et la panne qu'il provoque, quel que soit celui qui est remarqué en premier.
Questions fréquentes
#Quelle est la différence entre la détection de dérive et le monitoring ?
La détection de dérive compare votre configuration déclarée (une zone DNS, un fichier d'état IaC) à la ressource réelle pour repérer les modifications non autorisées, tandis que le monitoring vérifie si un service est réellement disponible et répond. Il vous faut les deux : la détection de dérive repère la cause, le monitoring repère l'effet.
#Une dérive DNS peut-elle se produire même si je ne touche jamais à mon fichier de zone ?
Oui. Les intégrations tierces, les CDN, les plateformes d'e-mailing et même le registrar lui-même peuvent modifier un enregistrement en dehors de votre processus de modification habituel : la zone peut donc dériver sans qu'aucun membre de votre équipe n'ait fait de modification.
#À quelle fréquence faut-il vérifier la dérive des enregistrements DNS ?
La vérification continue est la bonne pratique pour tout ce qui est exposé aux clients, car un enregistrement MX ou A qui a dérivé peut affecter la distribution des e-mails ou la disponibilité en quelques minutes. Si une vérification continue n'est pas possible, contrôlez les enregistrements les plus importants (A/AAAA racine, MX, TXT SPF/DKIM) au moins une fois par jour.
#La détection de dérive fonctionne-t-elle de la même façon pour les serveurs cloud que pour le DNS ?
Le principe de base est identique (comparer l'état déclaré à l'état réel et alerter en cas de différence), mais les mécanismes diffèrent. La détection de dérive cloud s'appuie généralement sur les API des fournisseurs, comme DetectStackDrift d'AWS ou le refresh de Terraform, tandis que la détection de dérive DNS repose sur des requêtes en direct auprès des serveurs faisant autorité, comparées aux valeurs d'enregistrement attendues.
Essayez avec un outil gratuit
Cet article vous a-t-il été utile ?